
09 缩放定律1
09 缩放定律1
Section titled “09 缩放定律1”在 LLM 里一次完整的训练成本非常高,所以寻来拿开始前需要考虑很多,例如架构,超参数等的设计。
此时 scaling law 就很重要,从一个小的低成本的模型,逐步推断大模型的行为效果等。将大部分的优化应用到小模型上,并推广到大模型上。
早期人们发现 Data Scaling 规律,也就是不需要改变太多的算法,只需要进一步扩大数据的规模,模型的能力就会提升。
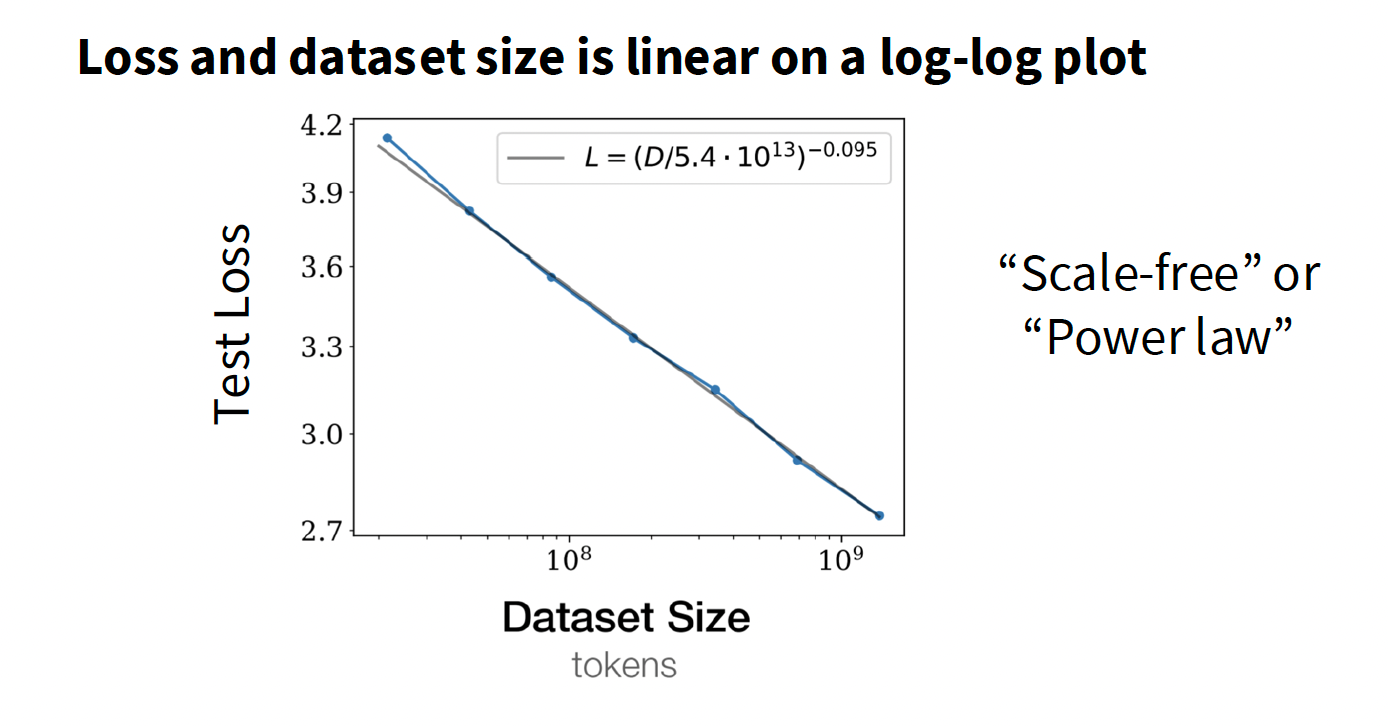
如果横纵坐标轴都是对数关系,随后图像构成线性,则数值构成幂律关系,这是大多 scaling law 的情况。
Data & Performance
Section titled “Data & Performance”例如下图,可以观察到在横坐标是对数坐标轴时构成了线性关系。
随着训练数据量增加,模型的泛化误差通常不是始终按同一种规律下降,而是会经历三个阶段。
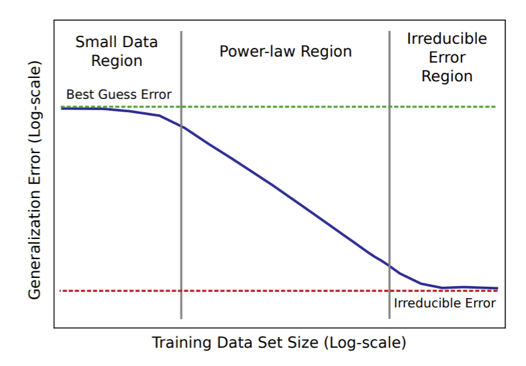
在上图中,横纵坐标轴都是对数,最左侧数据太少,模型无法学习到规律;中间进入 scaling law 区域,构成幂律关系;最右侧是数据增加也无法消除的误差,也就是 irreducible error(不可约误差)。
在中间段中,存在 curse of dimensionality(维度灾难)问题,例如 的关系下(这是一个经典的幂律关系),数据增大 10 倍,误差降低到原来的 63%,这里的指数 决定了增大数据的成本与收益。
Data Scaling 仅能告知模型本身的学习速度,还需要其他 scaling law 辅助。
Data & Model Size
Section titled “Data & Model Size”在确定模型架构时候,同样可利用 scaling law。如下图展示,LSTM 的截距比 Transformer 大,同时 scaling 之后表现不如 Transformer 稳定。
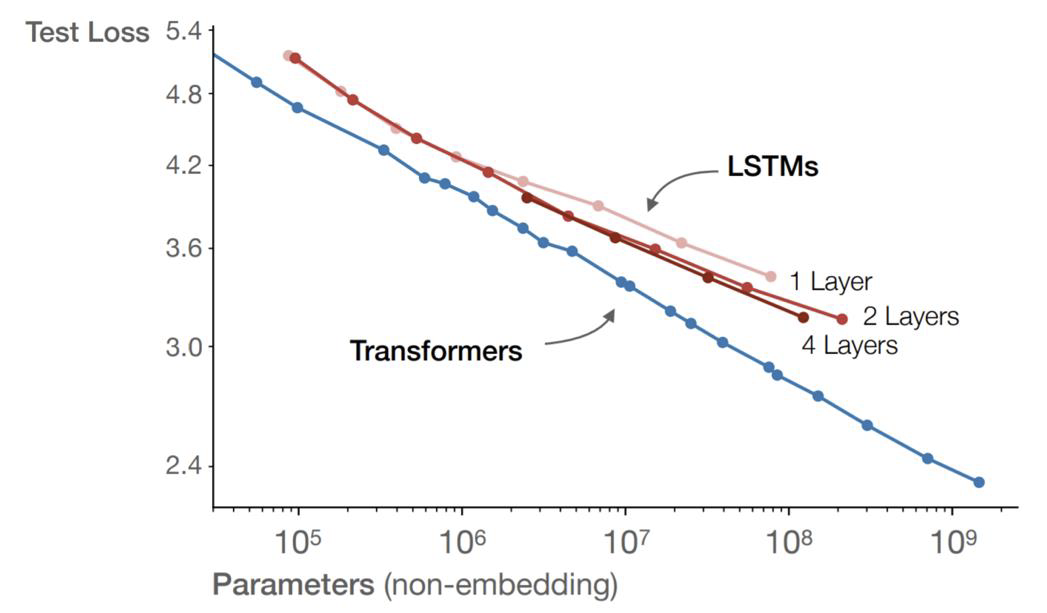
另外关于模型的层数,模型的维度数等等,这些都可以通过 scaling law 来尝试确定一个良好的比值,等等。
Hyper-parameters & Performance
Section titled “Hyper-parameters & Performance”Critical Batch Size
Section titled “Critical Batch Size”在设计 batch size,lr 这些超参数的时候,scaling law 同样发挥作用。
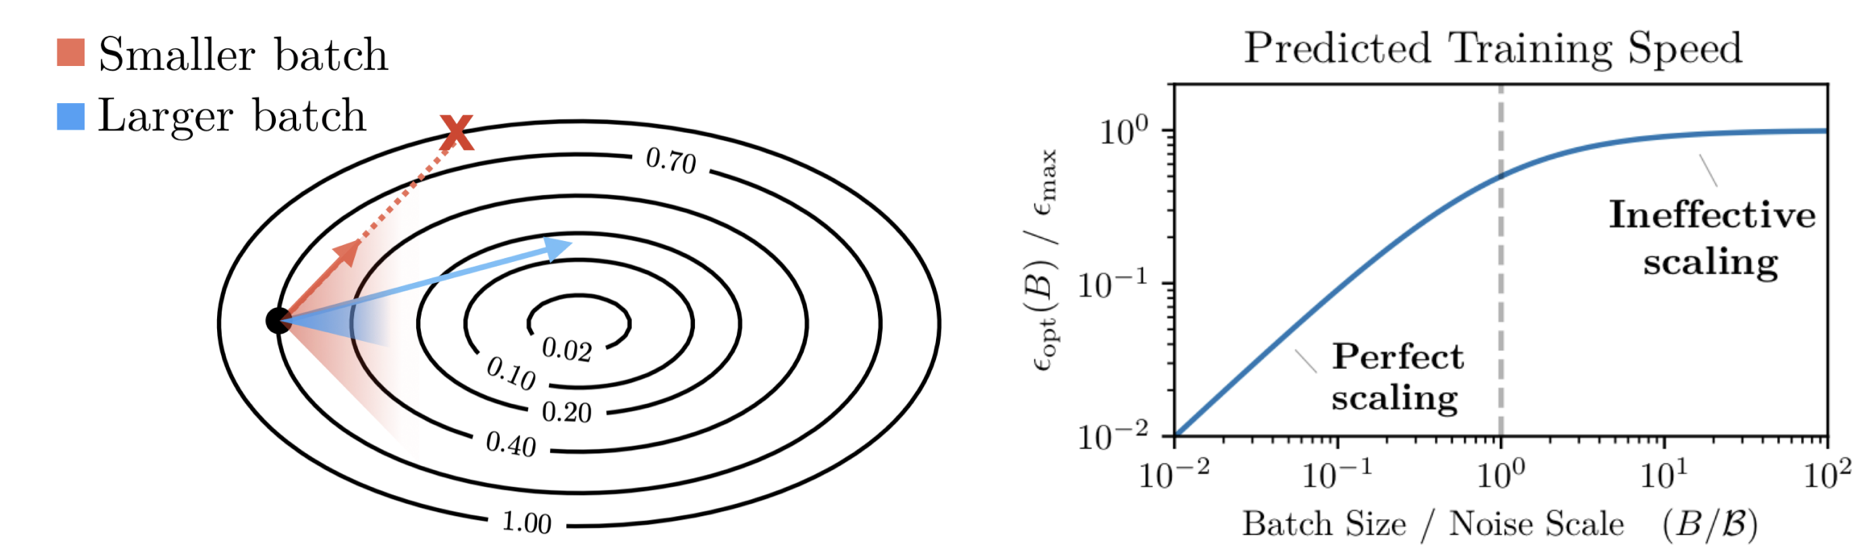
在 bs 较小时,对显存要求小,梯度噪声相对较大(这是好事),缺点是 GPU 利用率第,梯度方向抖动大。大 bs 让 GPU 并行能力增强,同时梯度值相对稳定,训练 step 数也逐步降低。
Critical Batch Size 是一个临界点,在超过该值后,继续增加 bs 不会导致训练 step 数量减少。这是因为梯度由真实梯度与噪声共同构成: 而噪声会随这 bs 的增大而下降 。在 bs 小时候噪声主导,增大 bs 会显著降低噪声,大 bs 时候收益就会非常微弱了。
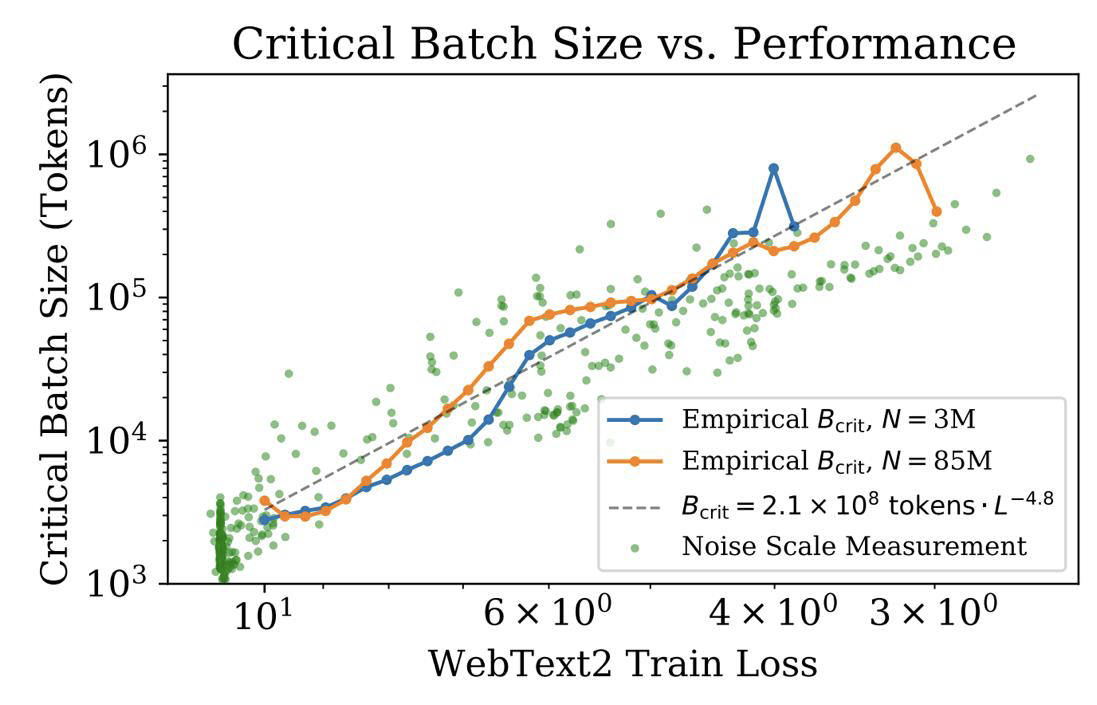
下图就展示了如何去估计一个临界 bs,可以加快训练的速度。
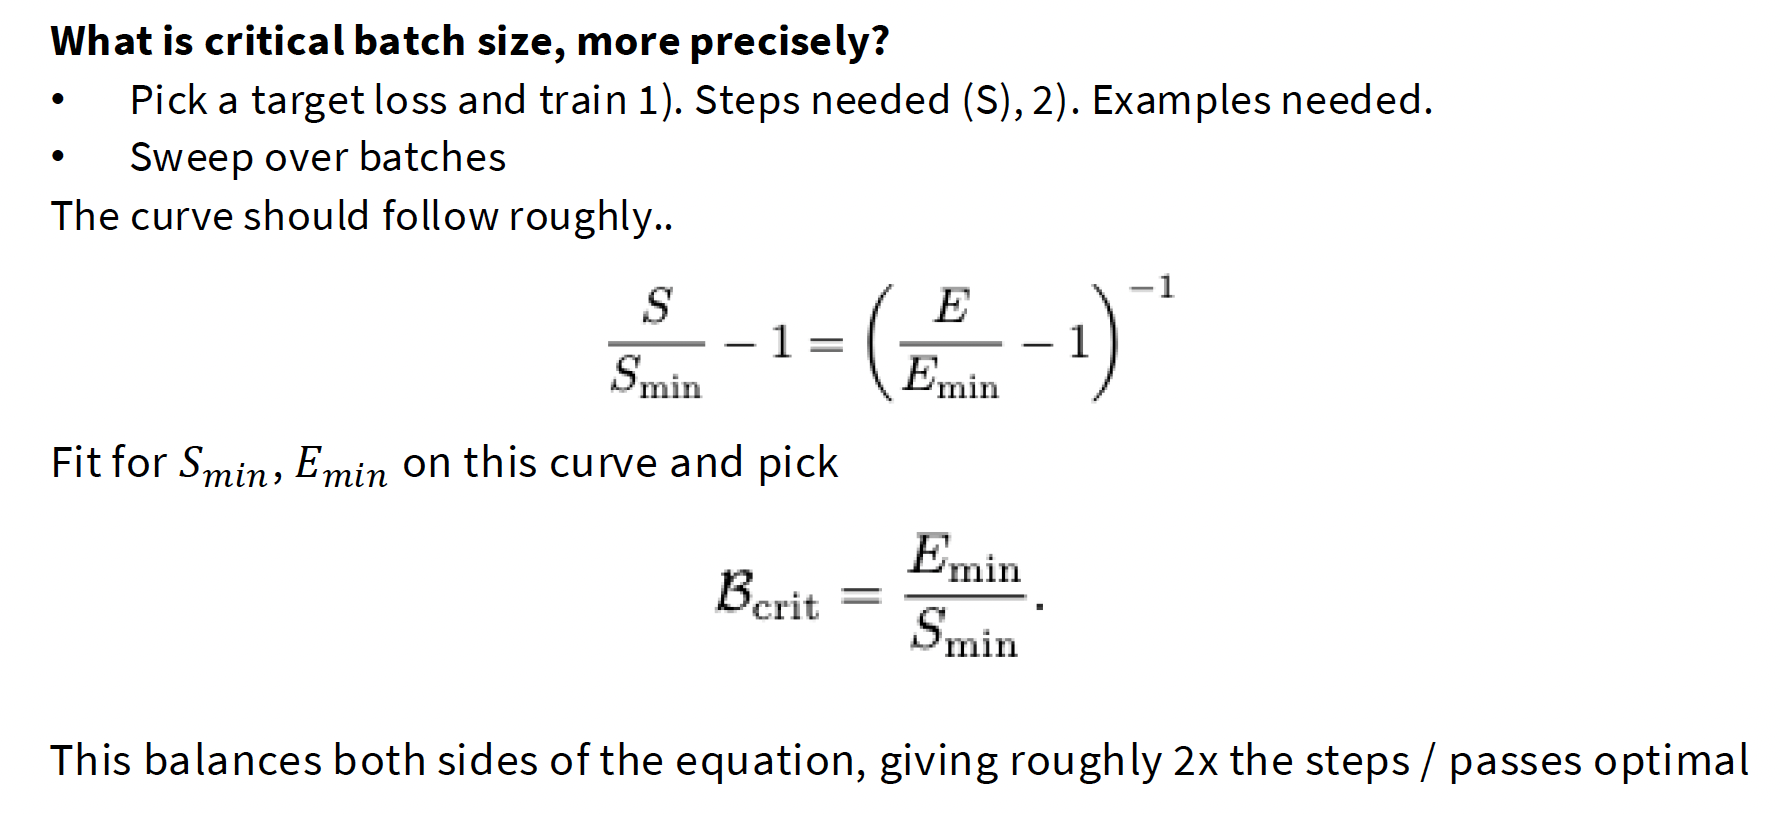
随着目标 Loss 的变化,Critical Batch Size 的大小也在发生变化,同样这也是一个幂律关系。
Learning Rate
Section titled “Learning Rate”经验法则,如果模型扩大 n 倍(例如 MLP 的宽度),则学习率就要同步缩小 n 倍,这个也是通过 Scaling Law 得出的。
总结来说 Scaling 的作用是让你执行真正的大规模训练前,能够预测到使用某种架构,或者某些参数之后,模型的实际效果将会是如何。
Data 还是 Model
Section titled “Data 还是 Model”到底是需要更多的数据,还是更大的 Model (也就是算力)
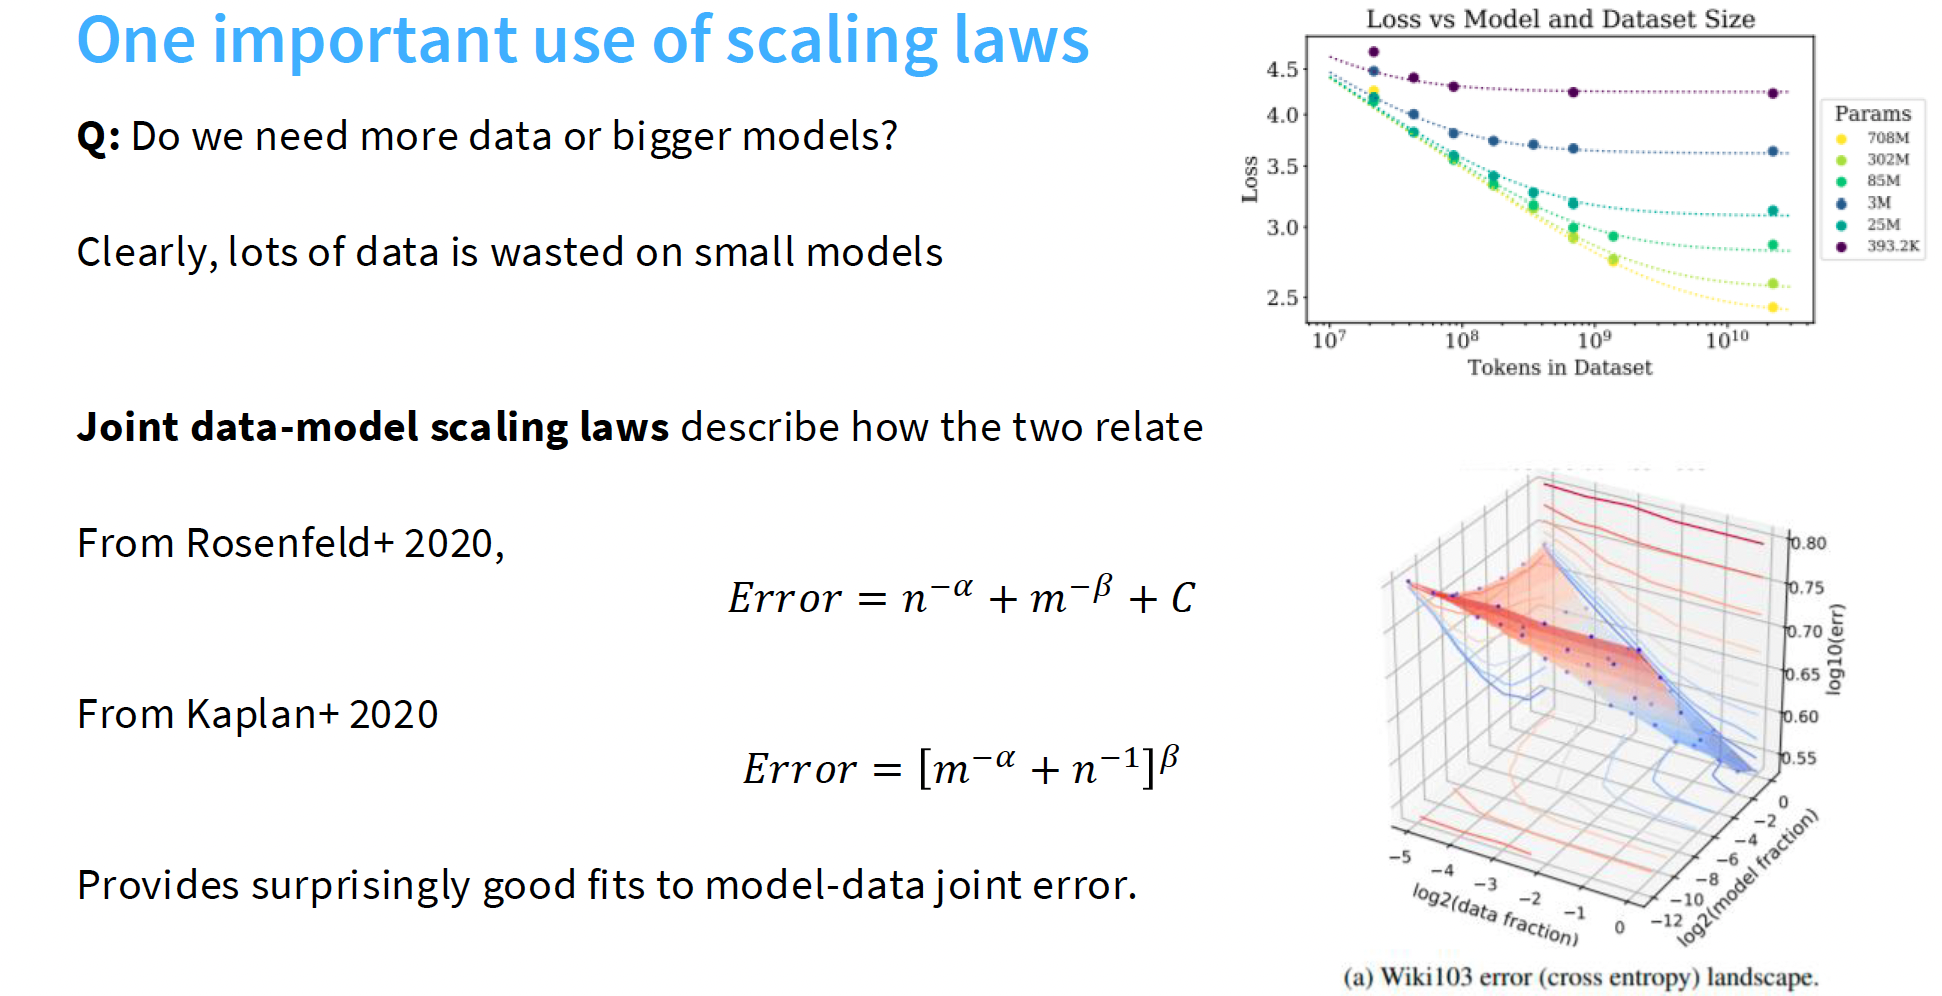
如果有无限的数据,则模型大小会构成 scaling;如果无限的模型大小,这会构成 data 的 scaling。
但是在后来,另一篇文章又提出了另一种情况
如何正确利用 Scaling Law
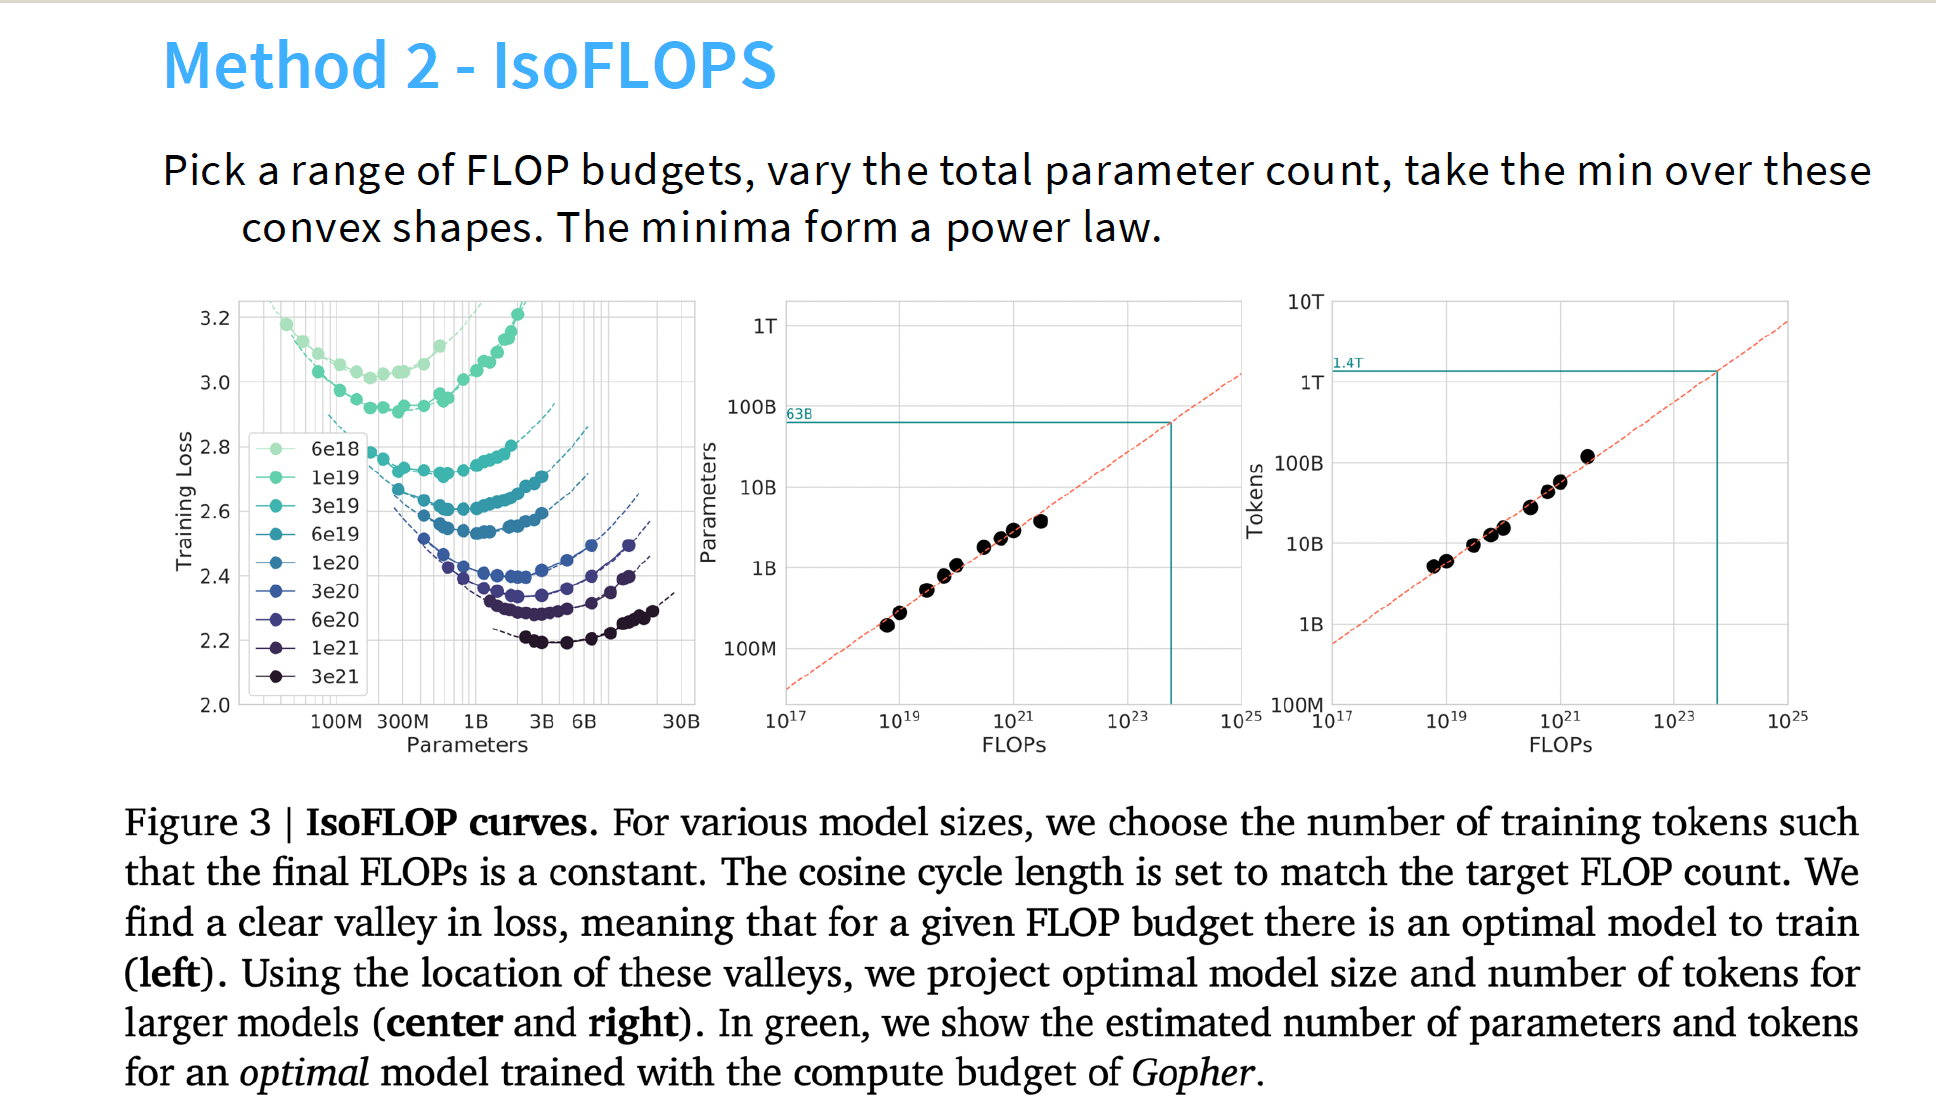
Section titled “如何正确利用 Scaling Law”训练模型,绘制不同大小模型和 loss 的下包络线,可以给出在给定计算量下,最好的模型效果。
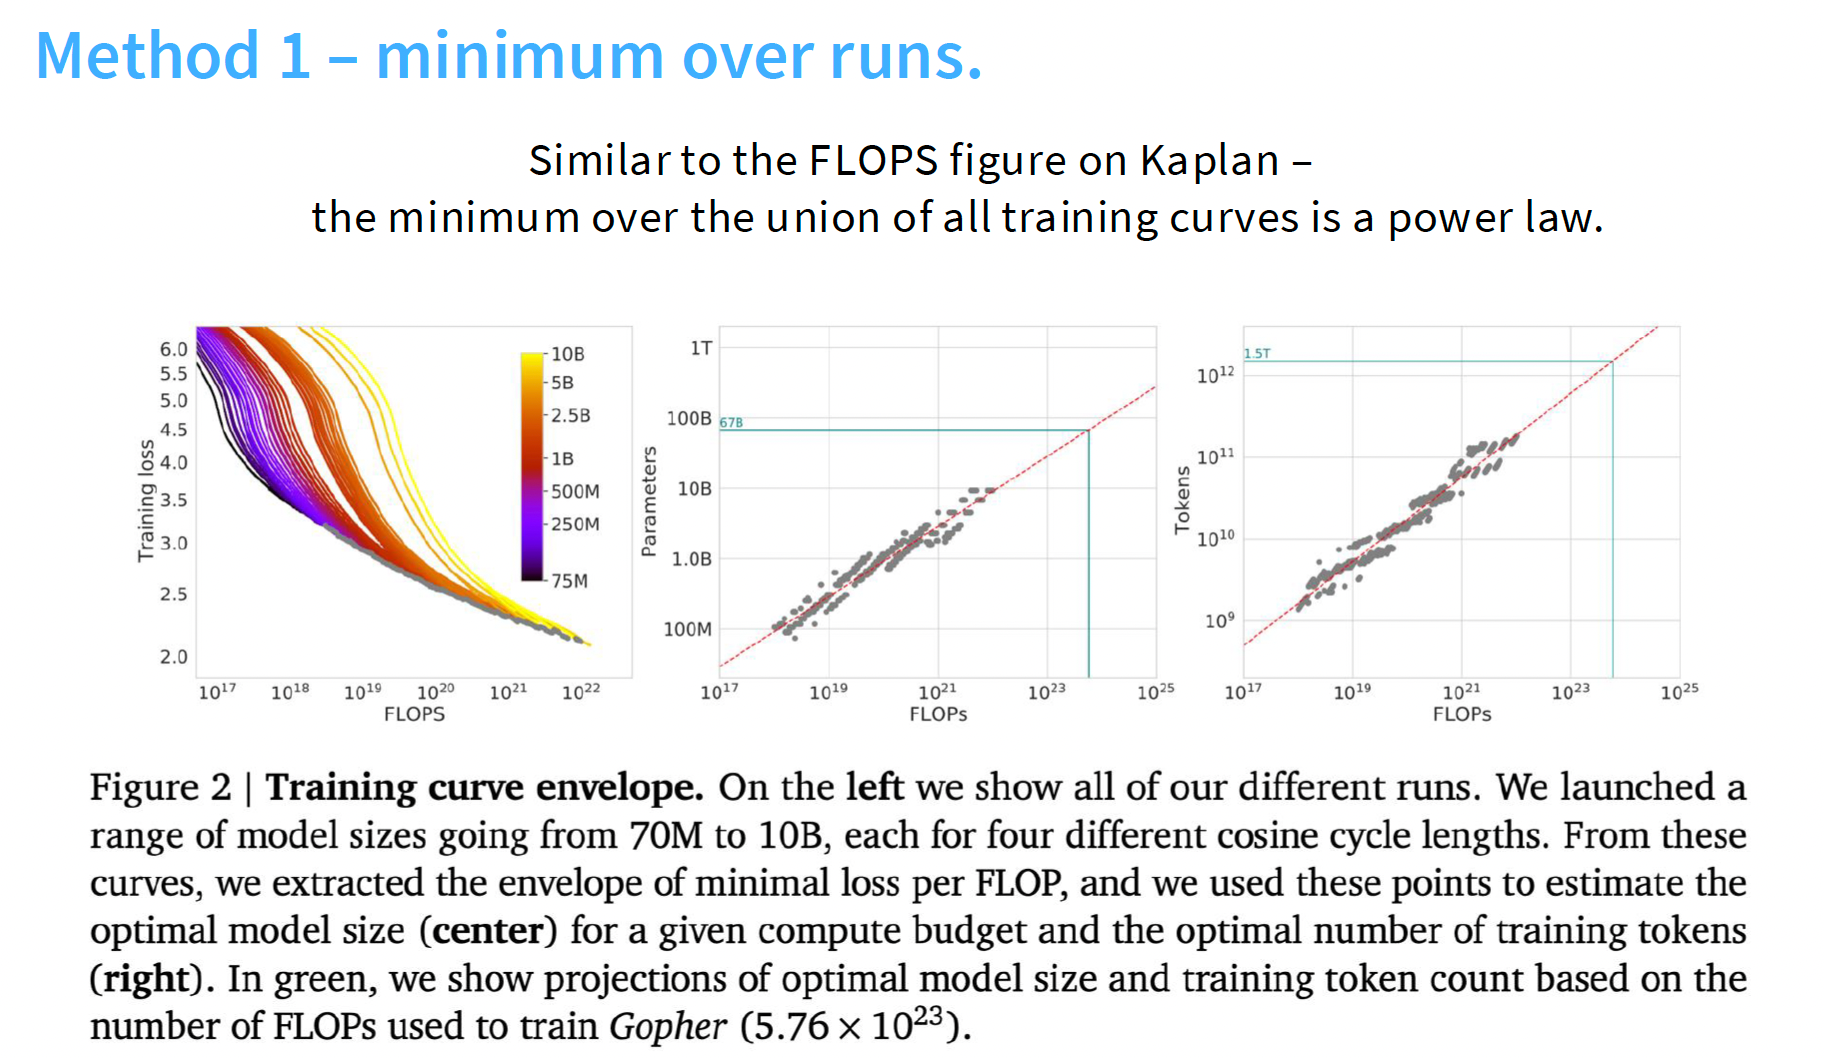
固定 FLOP 预算下,横向对比 Data 和 Model(可以找到一个最低点)
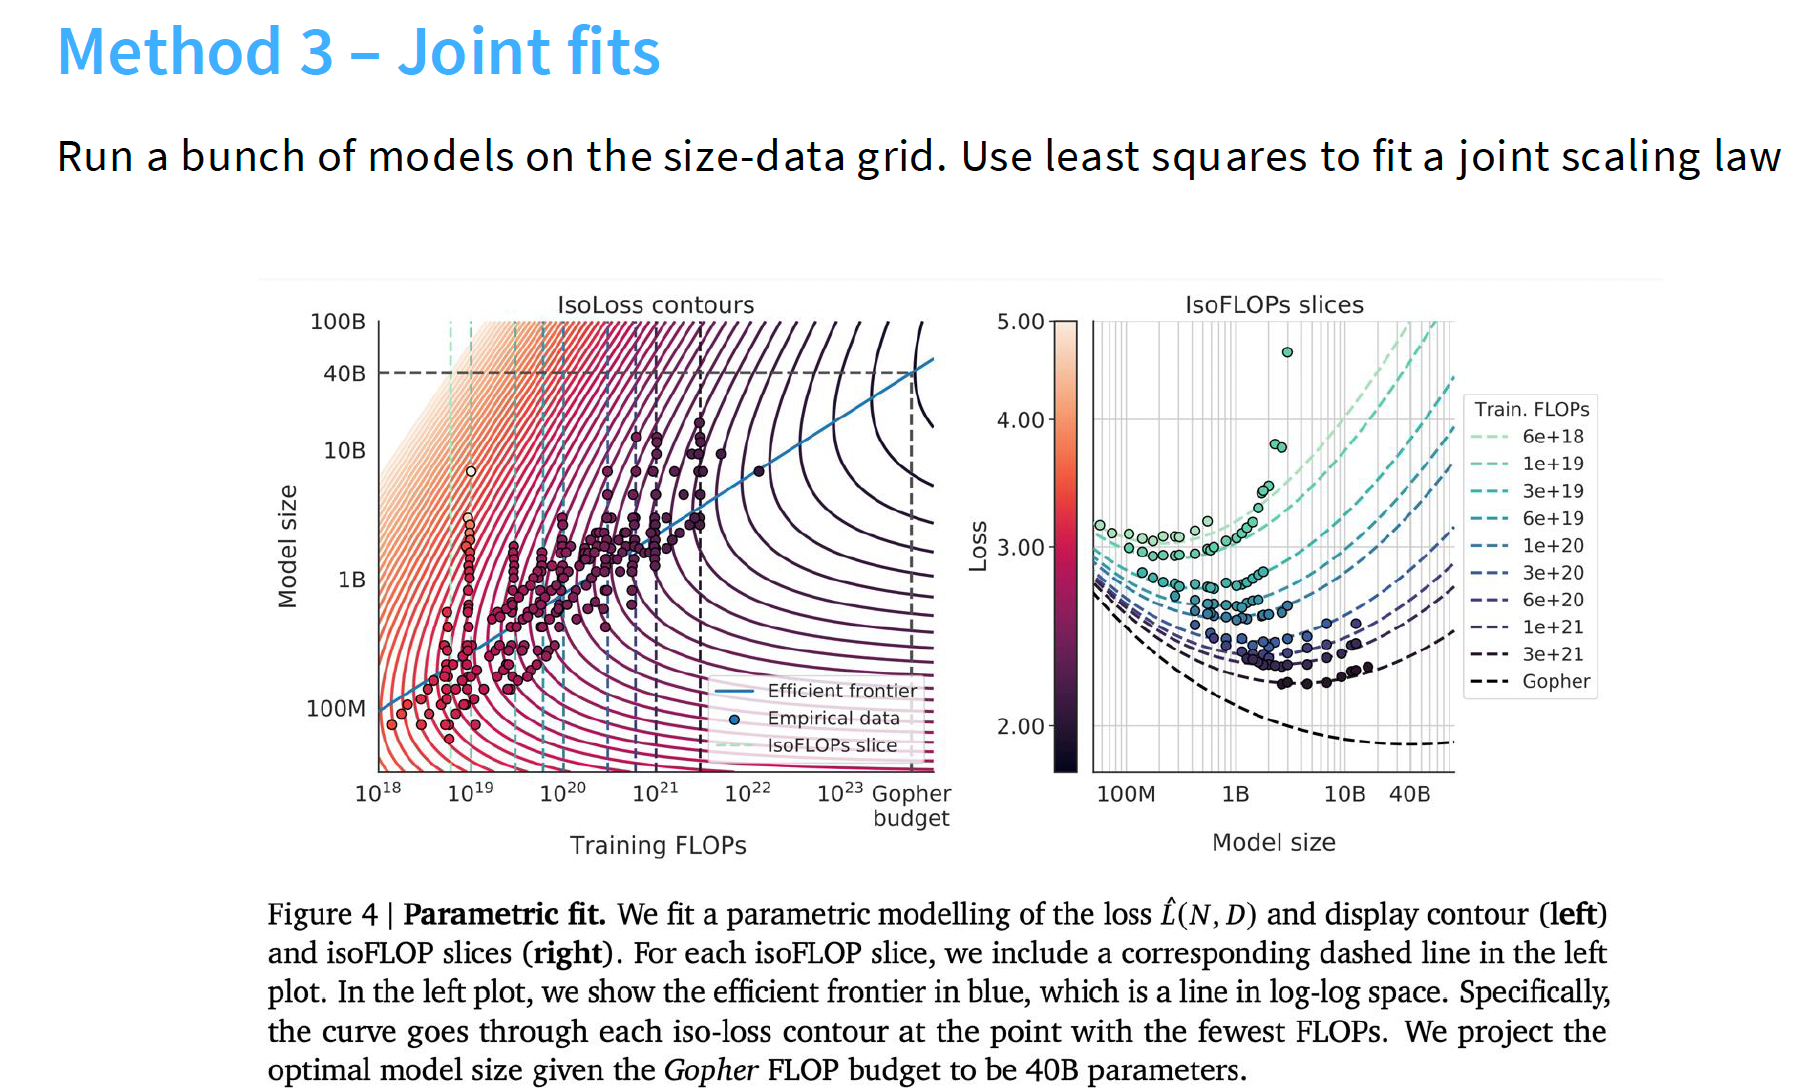
直接拟合这个 N 和 D 的曲面,将两个参数同时考虑进来。
Scaling Law 的形成
Section titled “Scaling Law 的形成”上述不同的 Scaling Law 之间会有巨大的差距,这是因为实验过程中的一些微小的决定,例如关于 FLOPs 的计算方法;修正小模型的 warmup,让模型正确收敛等。
因为如果在数值较小的情况下,一点误差会导致拟合的曲线发生较大的变化,同样也会导致 scaling 后期的数值发生较大的变化。
这里不再撰写,原视频中给出了较为详细的分析。