
07~08 并行化
07~08 并行化
Section titled “07~08 并行化”在上章节中我们认为 HBM 的速度相对较慢,但使用 DDP 时候 HBM 实际上是更快的层级速度:
- L1 cache / shared memory 等
- HBM
- NVLink / NVSwitch
- 不得已地使用 Ethernet
在多卡场景中,通信开销会更加的重要
分布式通信 / 运算
Section titled “分布式通信 / 运算”Distributed Communication / Computation
Collective Operation
Section titled “Collective Operation”Collective Operation(集合通信操作)意思在多个设备之间指定某种通信的方法,其中的每一个设备可以成为 Rank。
- Broadcast:一个人广播给所有人
- Scatter:分发数据,不同的人收到的数据不同
- Gather:和 scatter 相反,从不同人手中收集数据
- Reduce:多个 GPU 先运算,最后汇总到某一个 GPU 上
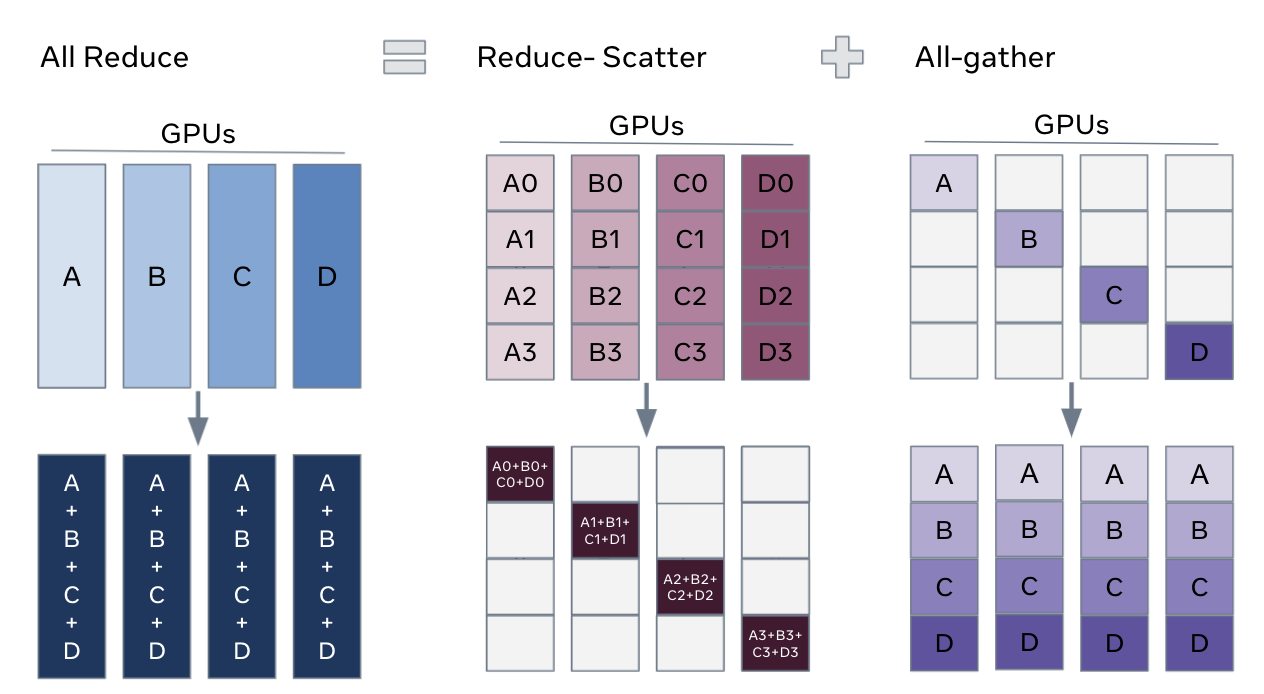
- All-Gather:将所有的数据整合起来,分发到每一个 Rank 上
- Reduce-Scatter:先 reduce 运算汇总到某一个 GPU 上,不同的 GPU 拿到不同的数值计算。
- All-Reduce:DDP 的核心,Reduce-Scatter + All-Gather,在多 GPU 计算完成后 广播给所有 GPU
- All-to-all: 类似于矩阵转置,将每一个 Rank 的数据重新分发到其他 Rank 中
NVIDIA Collective Communication Library (NCCL) 可以实现上述功能的代码撰写。
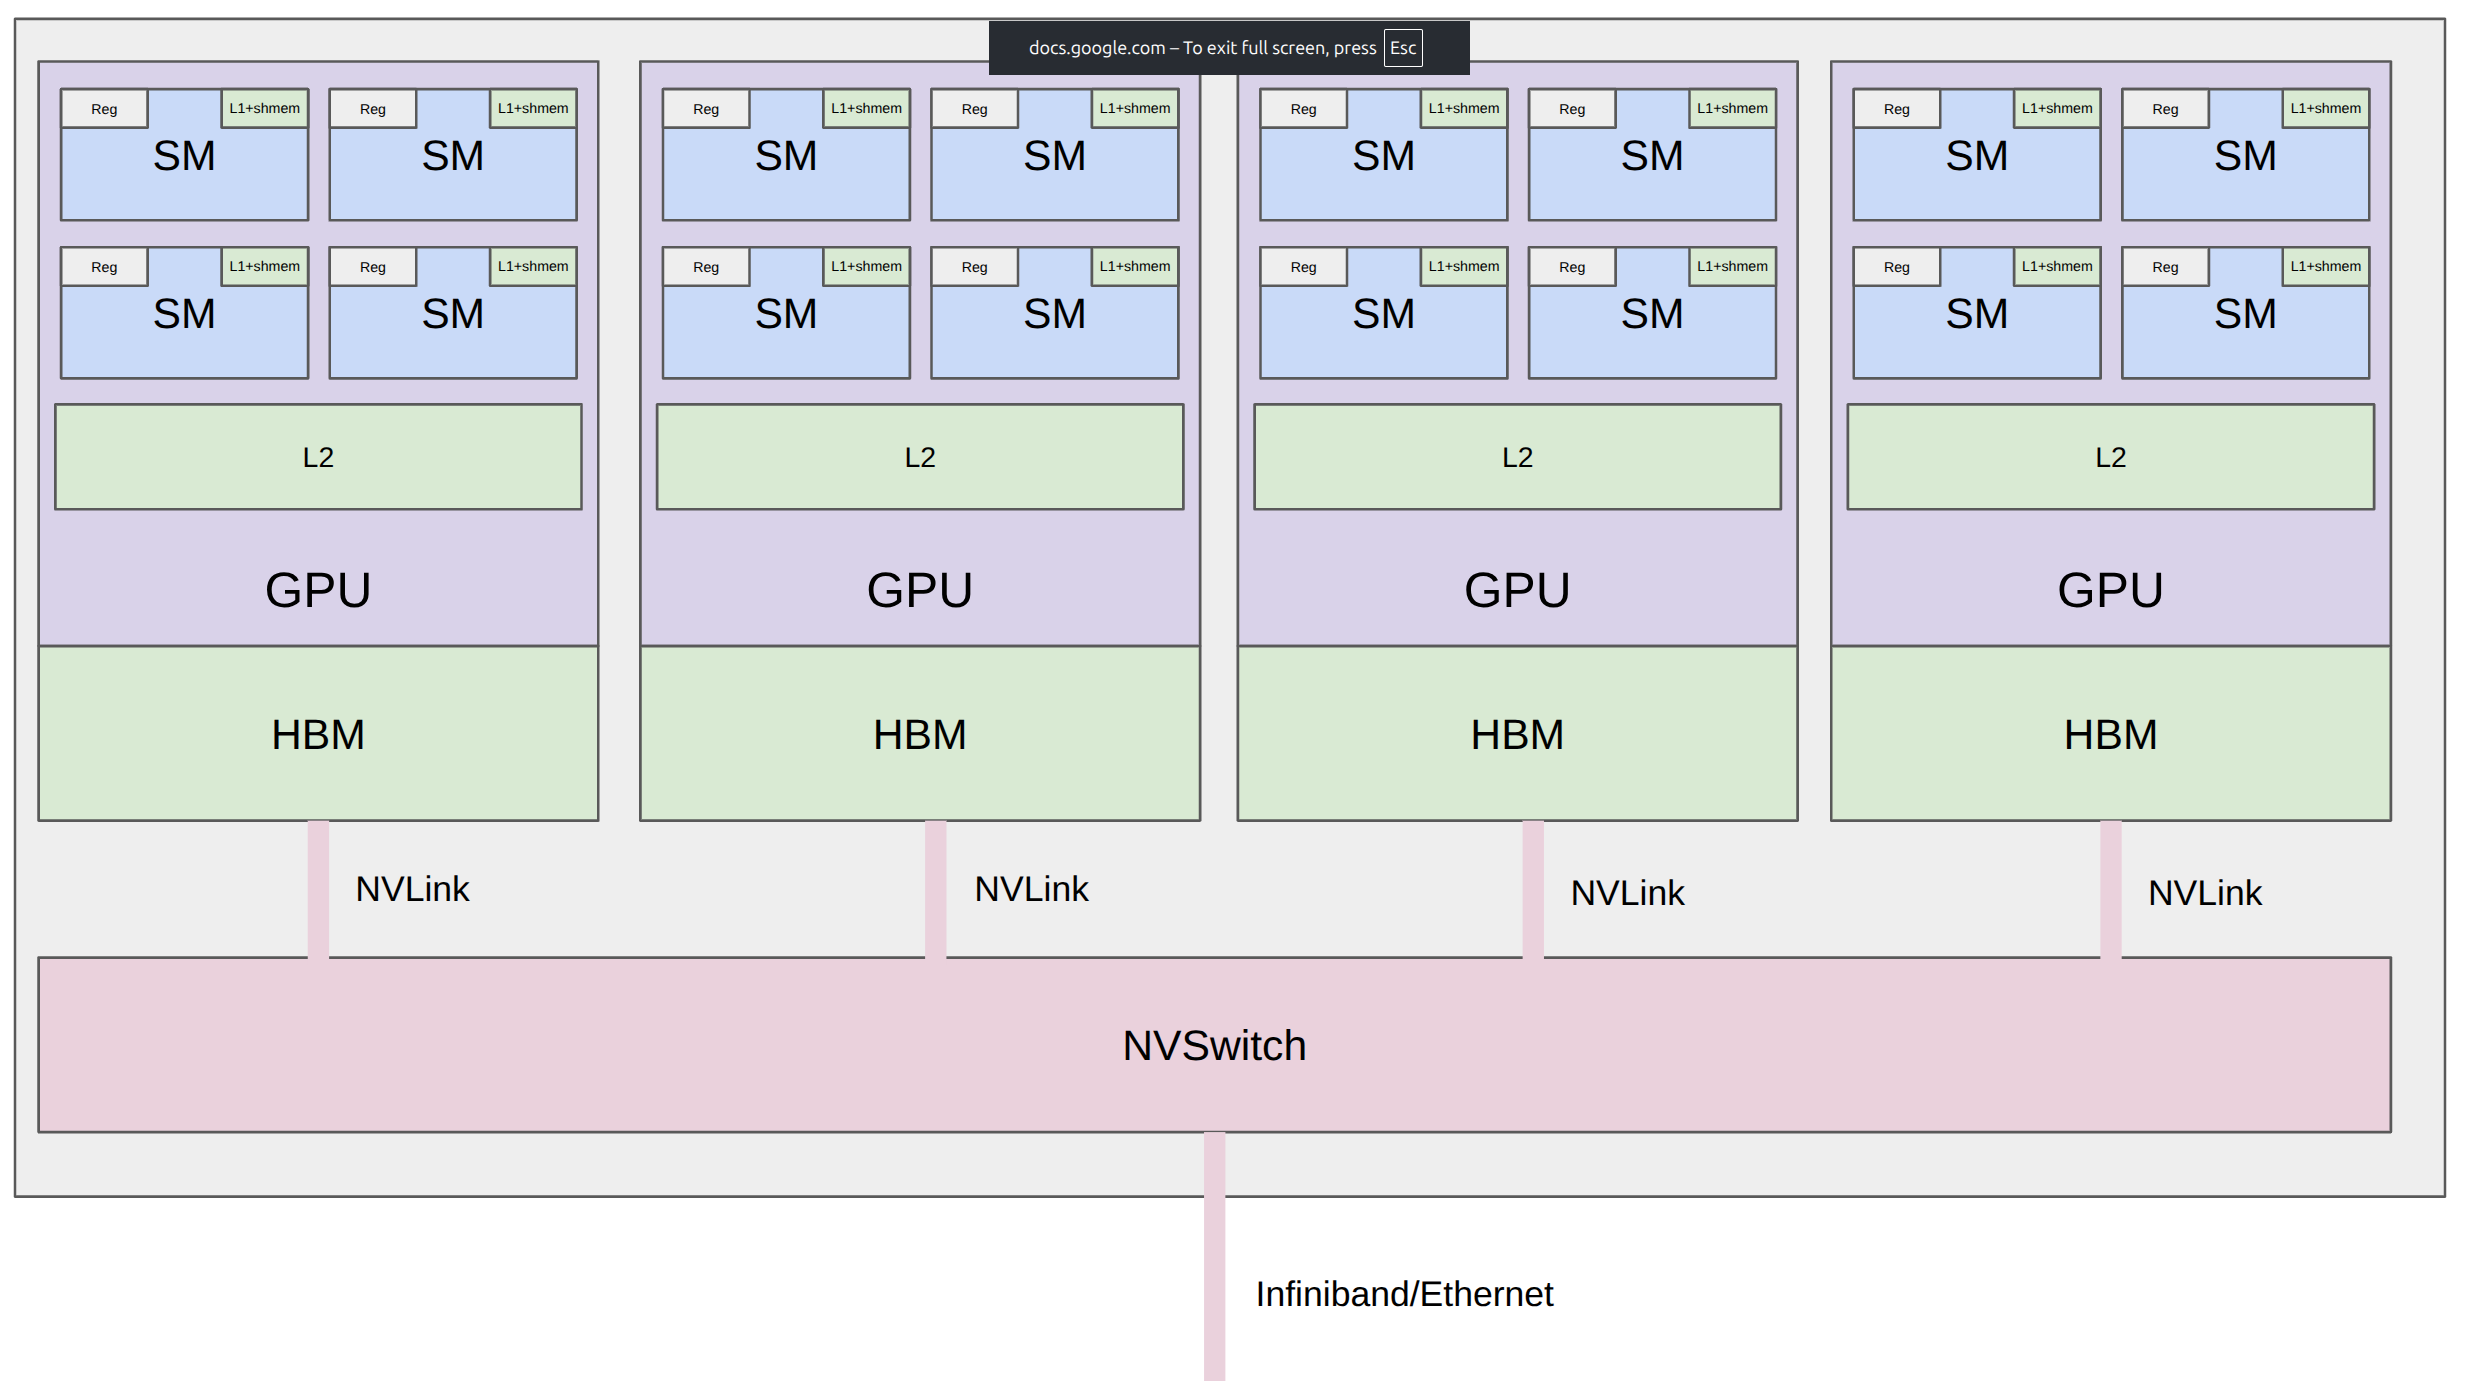
如果使用传统的 Ethernet 方式,那么所有数据得从 PCIe 给 CPU,由 CPU 构造数据包通过网络发送出去,这样的延迟会高很多。因而后面有的 RDMA 技术,让 GPU 可绕过 CPU 直接访问另一个 GPU 的数据。
Pytorch 编程
Section titled “Pytorch 编程”pytorch 提供了一个 torch.distributed 库来编程 DDP 的相关内容编程。
以一个 all-reduce 作为例子:
 def all_reduce(rank: int, world_size: int, num_elements: int):    setup(rank, world_size)  # @stepover
    # Create tensor    data = torch.randn(num_elements, device=cuda_if_available(rank))
    # Warmup    dist.all_reduce(tensor=data, op=dist.ReduceOp.SUM, async_op=False)    torch.cuda.synchronize()  # Wait for CUDA kernels to finish    dist.barrier()            # 同步所有 GPU
    # Perform all-reduce    start_time = time.time()    dist.all_reduce(tensor=data, op=dist.ReduceOp.SUM, async_op=False)    torch.cuda.synchronize()  # Wait for CUDA kernels to finish    dist.barrier()            # Wait for all the processes to get here    end_time = time.time()
    duration = end_time - start_time    print(f"[all_reduce] Rank {rank}: all_reduce(world_size={world_size}, num_elements={num_elements}) took {render_duration(duration)}", flush=True)  # @stepover
    # Measure the effective bandwidth    # 计算有效带宽,就是发送数据量 / 消耗的时间    dist.barrier()    size_bytes = data.element_size() * data.numel()    sent_bytes = size_bytes * 2 * (world_size - 1)  # 2x because send + receive, world_size-1 steps in all-reduce    total_duration = world_size * duration    bandwidth = sent_bytes / total_duration    print(f"[all_reduce] Rank {rank}: all_reduce measured bandwidth = {round(bandwidth / 1024**3)} GB/s", flush=True)
    # Notes:    # - Effective bandwidth ~ 2 * size_bytes / total_duration    # - Independent of world_size    # - Independent of topology (ring or tree)
cleanup() # @stepover如果想要提升 DDP 的效率,需要管理不同 rank 上的数据并合理地执行同步,同时才需要规划通信和计算之间的切换。
data parallelism
Section titled “data parallelism”for param in params: dist.all_reduce(tensor=param.grad, op=dist.ReduceOp.AVG, async_op=False)也就是使用 all_reduce 来平均化所有的梯度。有点类似于 batch size 的作用,另外 rank 数量一般称为 world size,良好的 bs 应该是 world size 的倍数。
all reduce 的缺点是需要将所有的模型参数都加载到存储中,每一个 rank 作用类似于一组 batch。
data parallelism 需要传输的是 2 倍参数量的数据,并且完全没有节约内存。
tensor parallelism
Section titled “tensor parallelism”使用 all gather 聚合所有数据,允许只把一部分矩阵的激活值加载到 rank 中(因此不用把一个模型全部加载到一个 GPU / Rank 中),这种方法称为 tensor parallelism,利用矩阵运算允许切片的性质。
前向传播的时候使用 all gather,反向传播需要使用 ruduce scatter。
# Allocate memory for activations (world_size x batch_size x local_num_dim)activations = [torch.empty(batch_size, local_num_dim, device=cuda_if_available(rank)) for _ in range(world_size)]
# Send activations via all gatherdist.all_gather(tensor_list=activations, tensor=x, async_op=False)
# Concatenate them to get batch_size x num_dimx = torch.cat(activations, dim=1)既然优化器占据了大部分的存储(data parallel 需要在每一个 GPU 复制一份优化器),那么考虑将优化器本身拆分。当然这是有代价的,baseline 的速度是最快的,本方法需要付出更多的通信代价。
Stage 1 共享优化器
Section titled “Stage 1 共享优化器”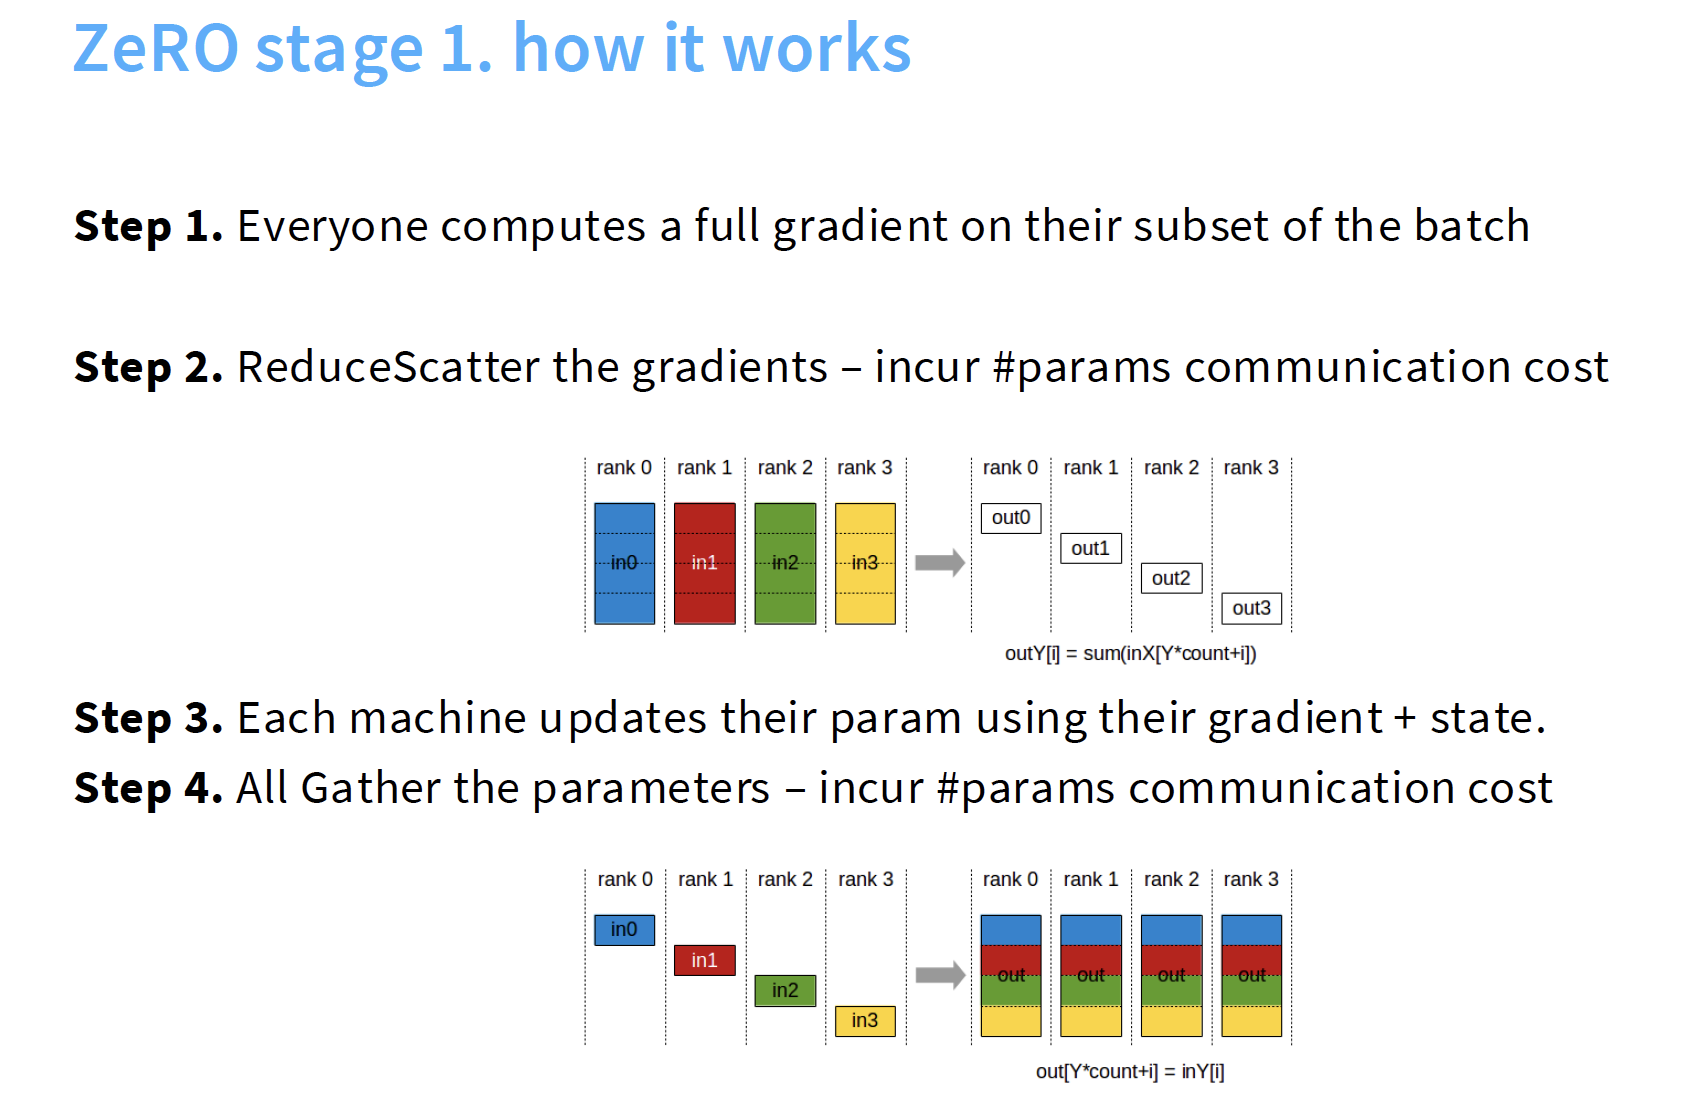
本方法中使用一次 reduce scatter + all gather,本质上等于一次 all reduce,也就是朴素 data parallel 算法的通信开销成本,近乎免费的内存节省。
Stage2 共享梯度
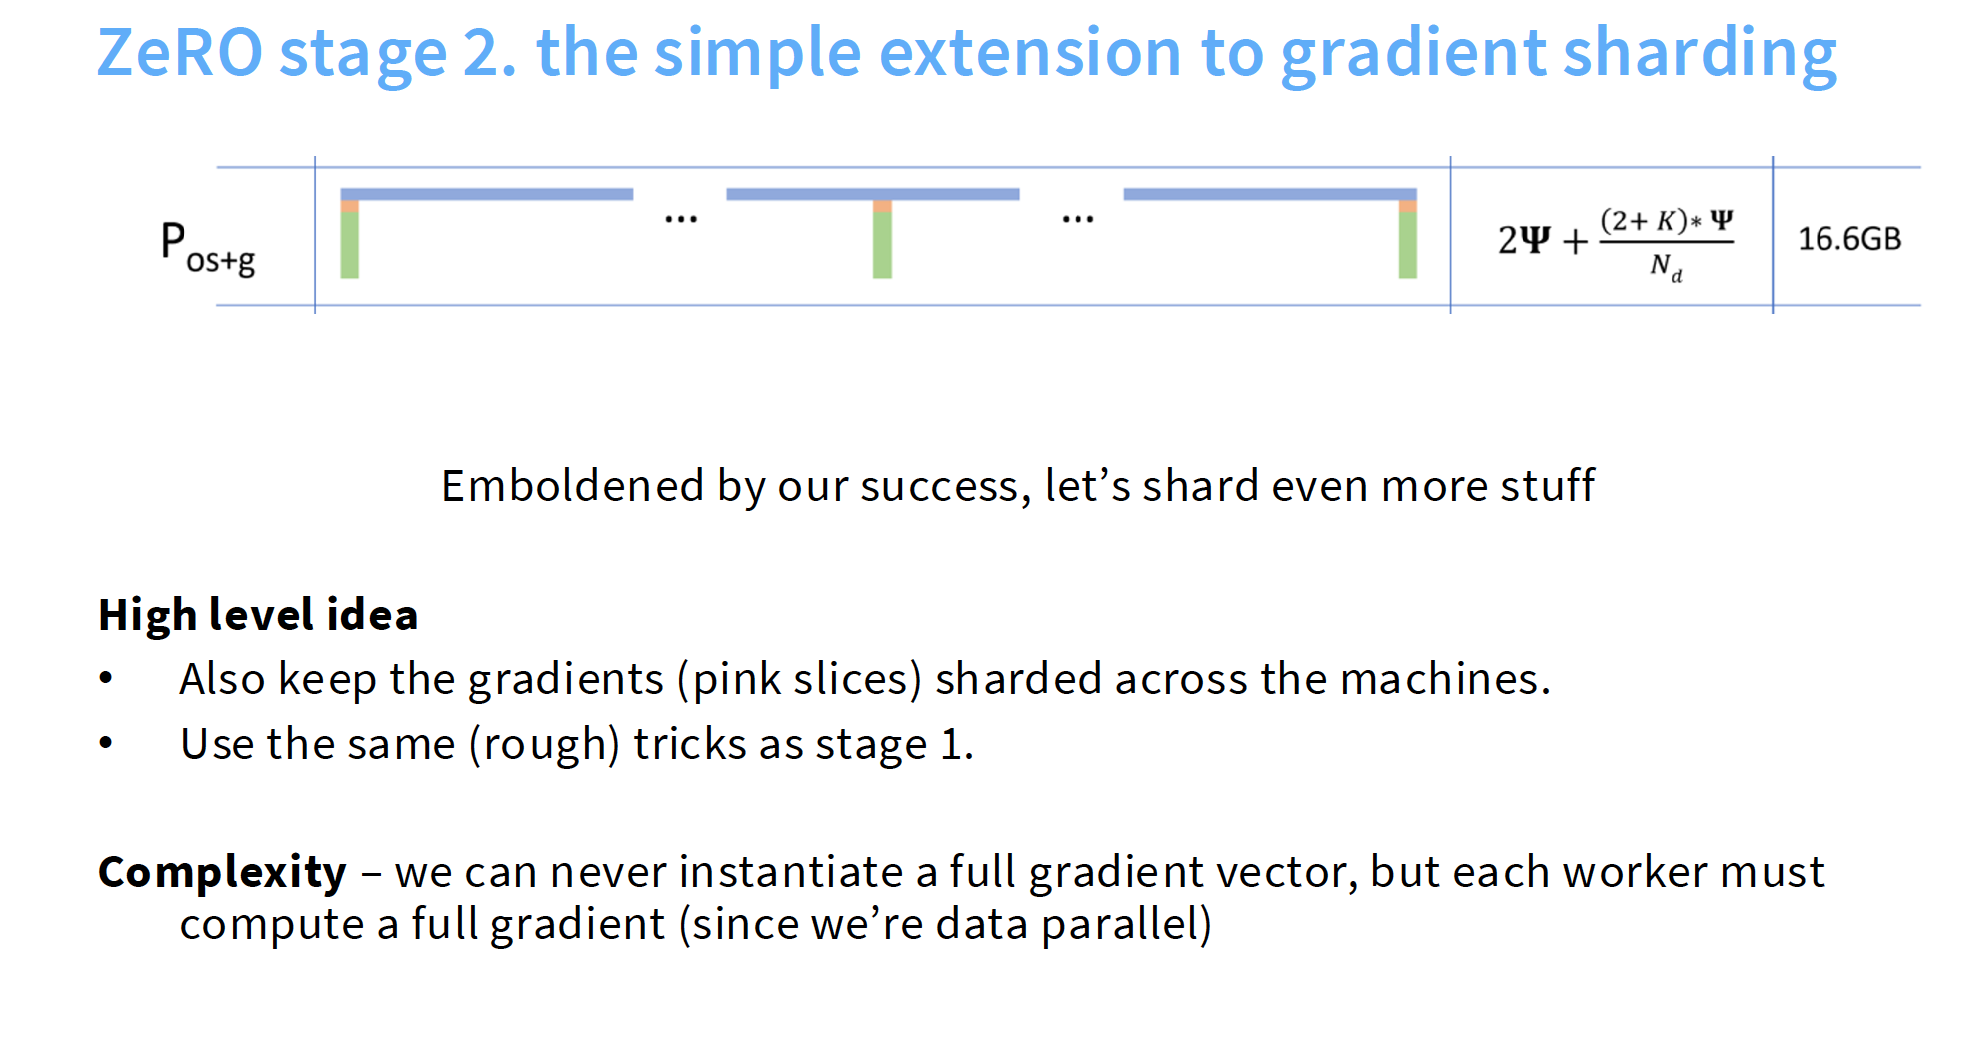
Section titled “Stage2 共享梯度”在方向传播的时候,沿着计算图进行遍历,并逐步发送计算的梯度,一旦本节点已经计算完毕就可以直接释放。
Stage 3 共享所有数据(FSDP)
Section titled “Stage 3 共享所有数据(FSDP)”参数,梯度,以及优化器状态,全部都共享。
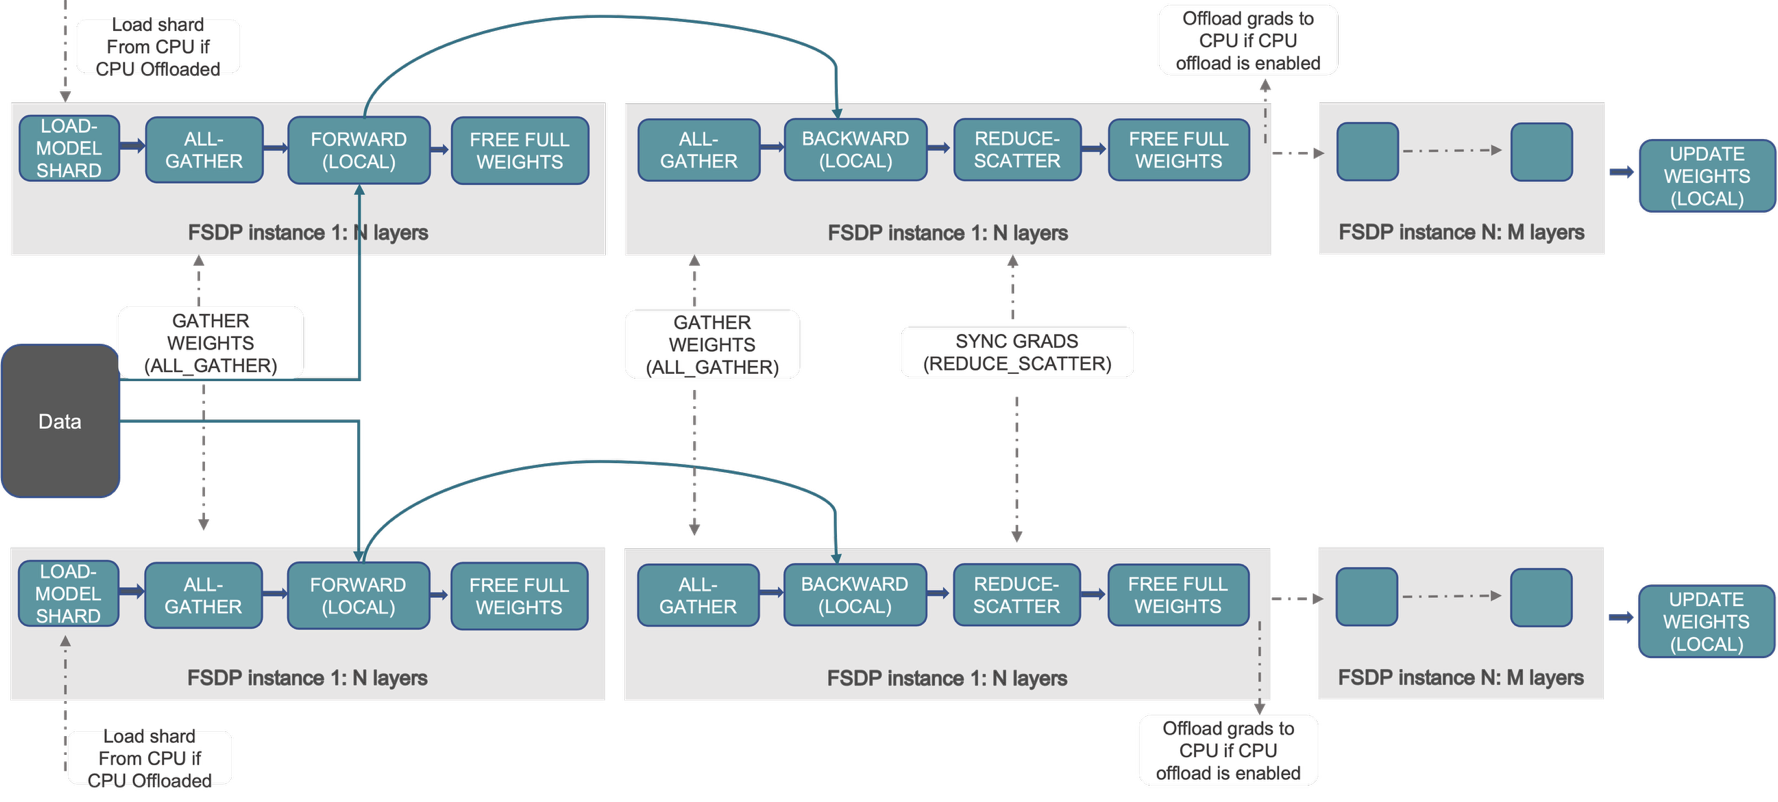
- 加载模型本体,执行一次 all gather 用来进行前向传播,对于 N 个 layer,一旦前向传播完成了某一层即可立即释放对应的参数。
- 在进行反向传播的时候,需要本层参数的激活值,通过 all gather 拿出来,然后 ruduce scatter 方式计算梯度,在计算完成后就可以释放 weights
在 stage 3 中多了一次 all gather,通信成本会有所上升,但是可以通过一些系统性的优化来弥补这一点,也就是将计算和通信同时并行,在计算的同时执行内存请求等。在计算量足够大,并且通信速度足够快时,可以 cover 掉这一部分的时间损耗。
上述方法有一个先决条件,就是 Batch Size 应该要比计算节点数多。然而节点数量是可以一直增长的,但是 batch 数量有临界值,不可以持续增长。
另外 Stage1 和 Stage2 方法中,只优化了 Gradient 以及 Optimizer 的存储,其他的系统存储都没有减少。
Layer-wise Parallel
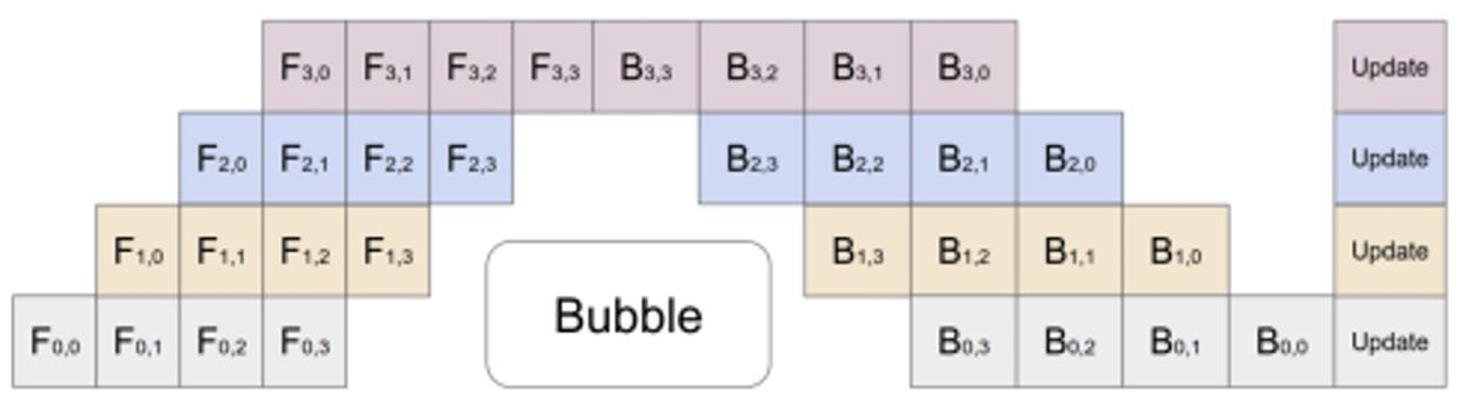
Section titled “Layer-wise Parallel”所以可以想到一种方法,把一个模型的不同层切分到不同的 GPU 上。显然由于每一层需要上一层的值才可以继续计算,所以这会造成 GPU 的空闲。解决的方法就是流水线(pipeline parallel)扩大批次,让 GPU 在算完以后立刻需要算另一批次的值,如下图:
Tensor Parallel
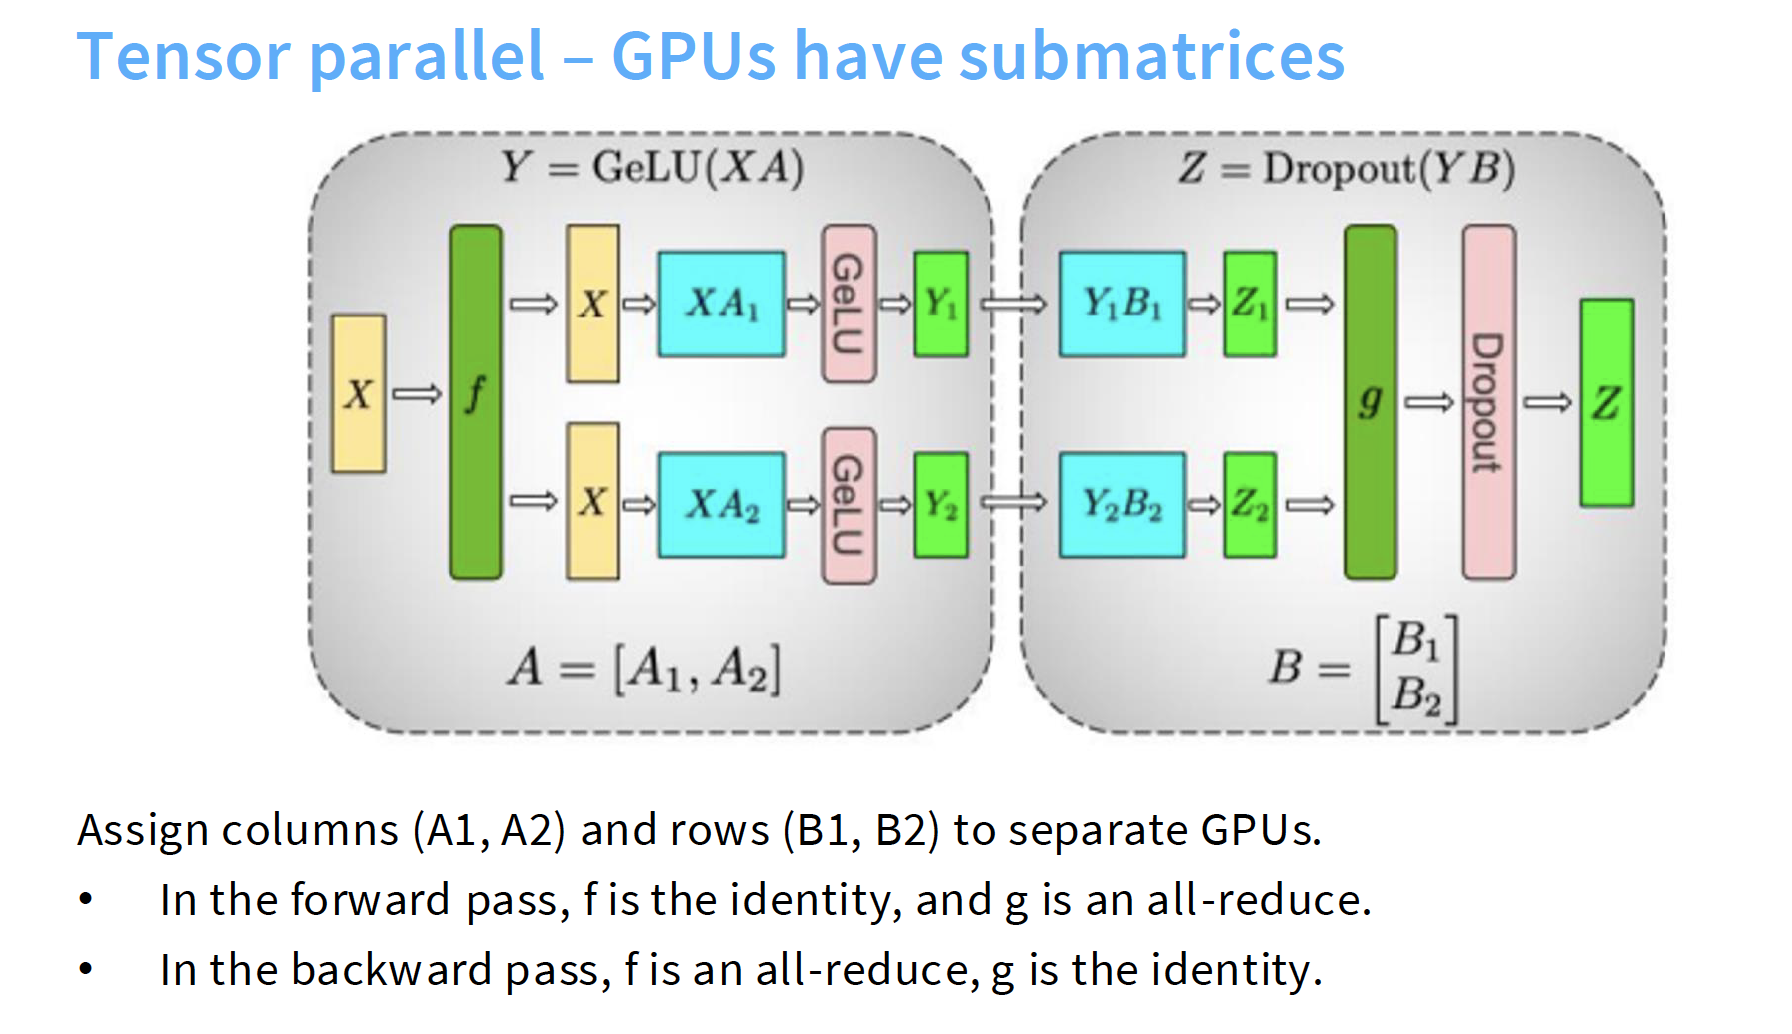
Section titled “Tensor Parallel”除了切分模型,还可以切分模型的每一个矩阵,也就是上文提到的 Tensor Parallel 算法。
对于不同的计算步骤,可以切分的方法也不同,可以横向也可以纵向。使用的时候正向和反向分别都需要一个 all reduce,因此通信的开销会非常大(而且通信是 all to all 的),尽可能仅在一个服务器(8个GPU内)使用这个算法。
下图展示了分别为按列切分以及按行切分的两种算法
在整个运算工程中,显存的占用量实际上是动态的
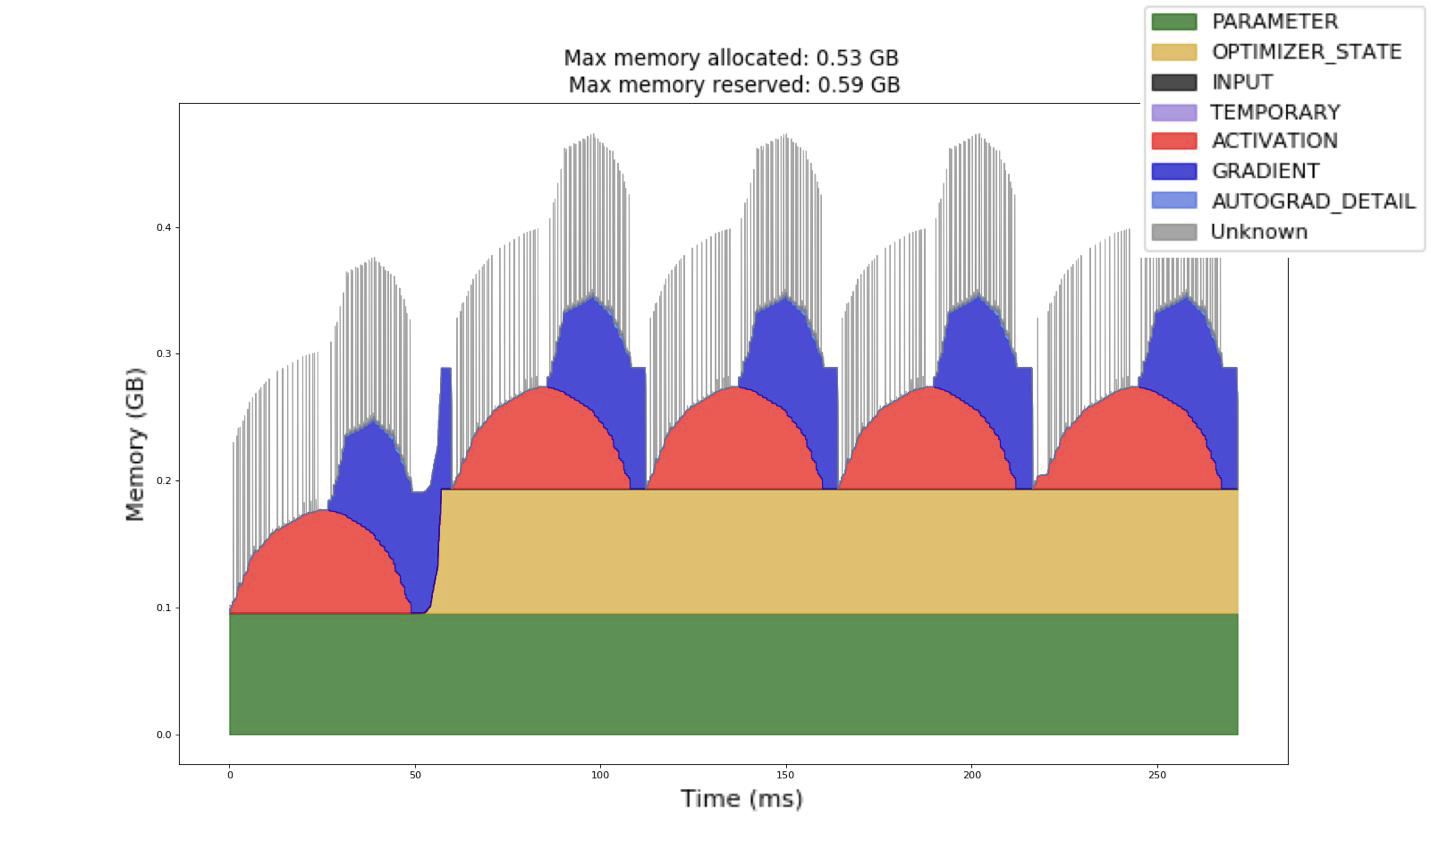
在 Forward 完成后,刚开始 backward 的时候占用实际上是最高的,需要同时存储激活值以及反向传播的梯度等数据。所以后续的优化方向,都尽可能为了减少这个时候的尖峰。
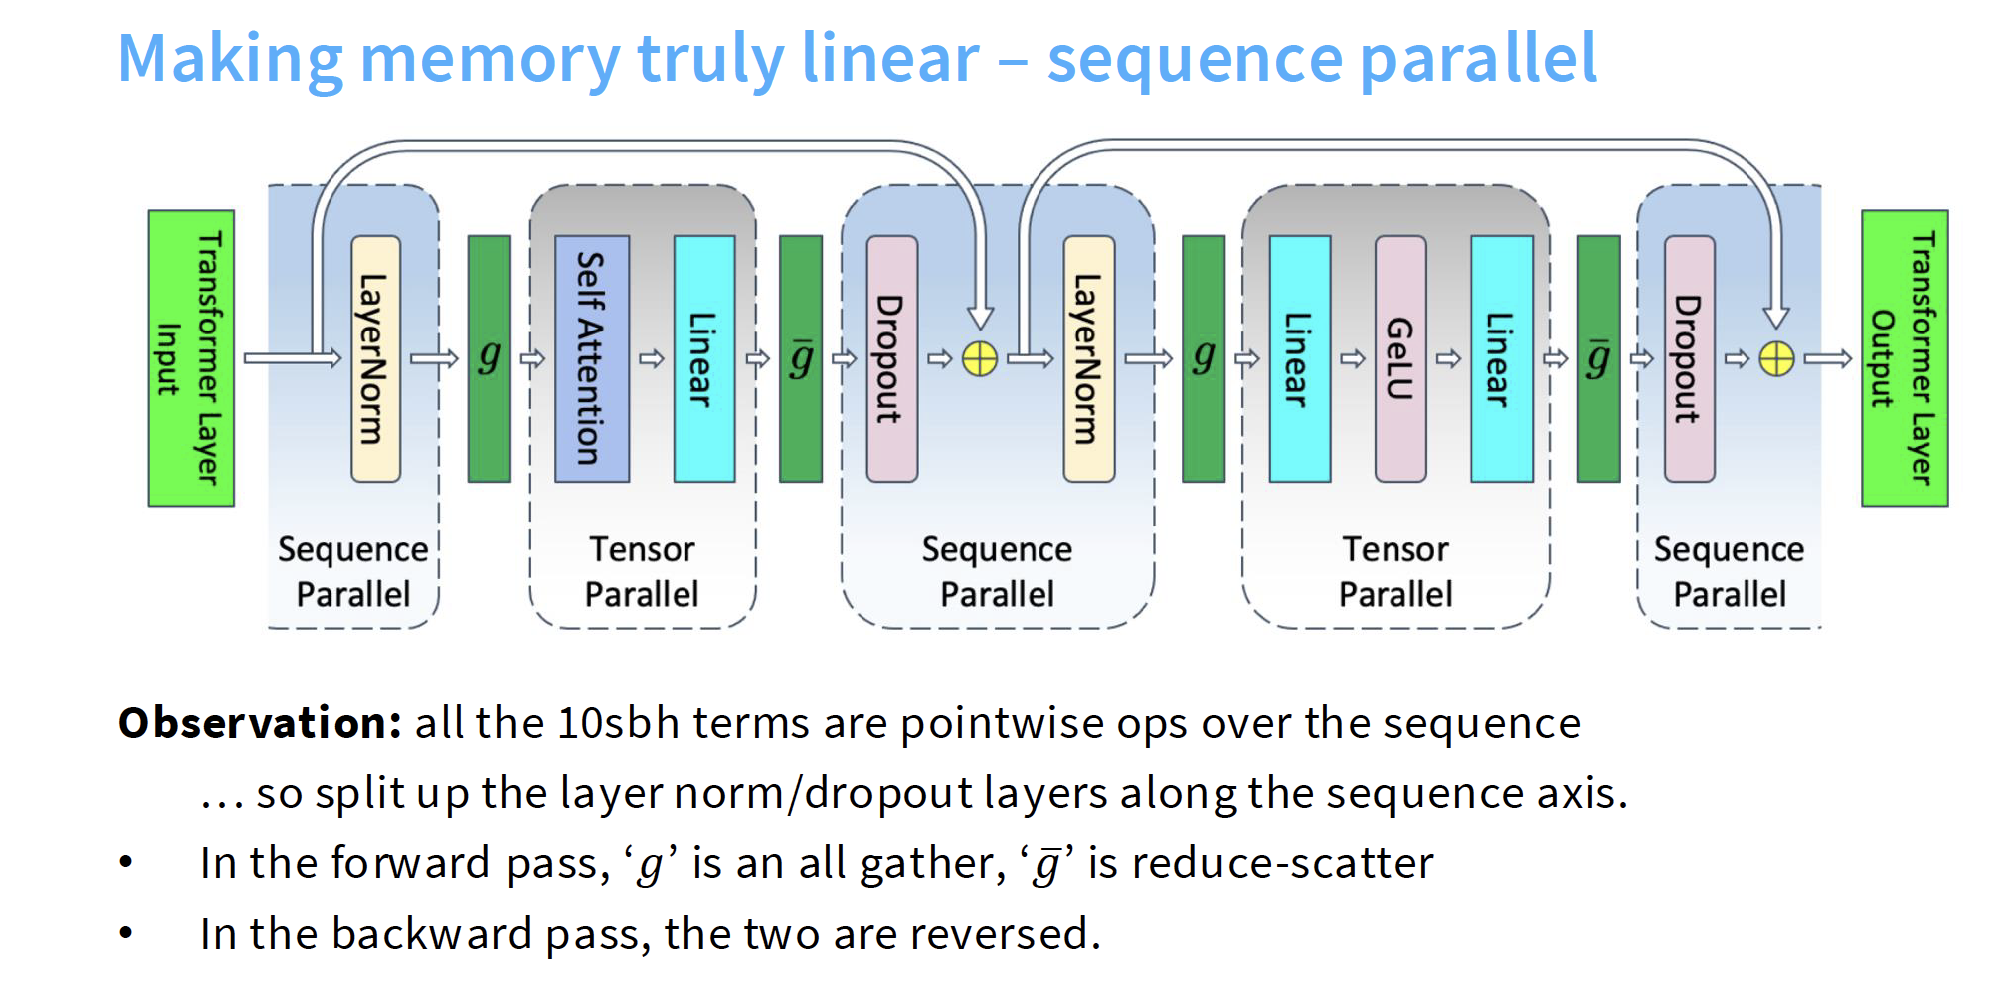
Sequence Parallel
Section titled “Sequence Parallel”也称为 Context Parallel,和 FSDP 的思想很相似。沿着 sequence 维度来拆分而不是 hidden 维度。
Expert Parallel
Section titled “Expert Parallel”在 LLM 中 MOE 架构已经非常常见,Expert Parallel 有点类似于 Tensor Parallel,但是更加高效,用于将 token 路由到对应的 expert 下去。
在遇到 FC 层进行路由 token 时,后续的计算必须等待所有的 token 到达才可以继续进行,所以路由操作对延迟非常敏感。同时仅对 MLP 执行并行化,Attention 的计算也同样需要,如果对 Attention 执行 Tensor Parallel 则会反过来影响 MLP 的并行化。
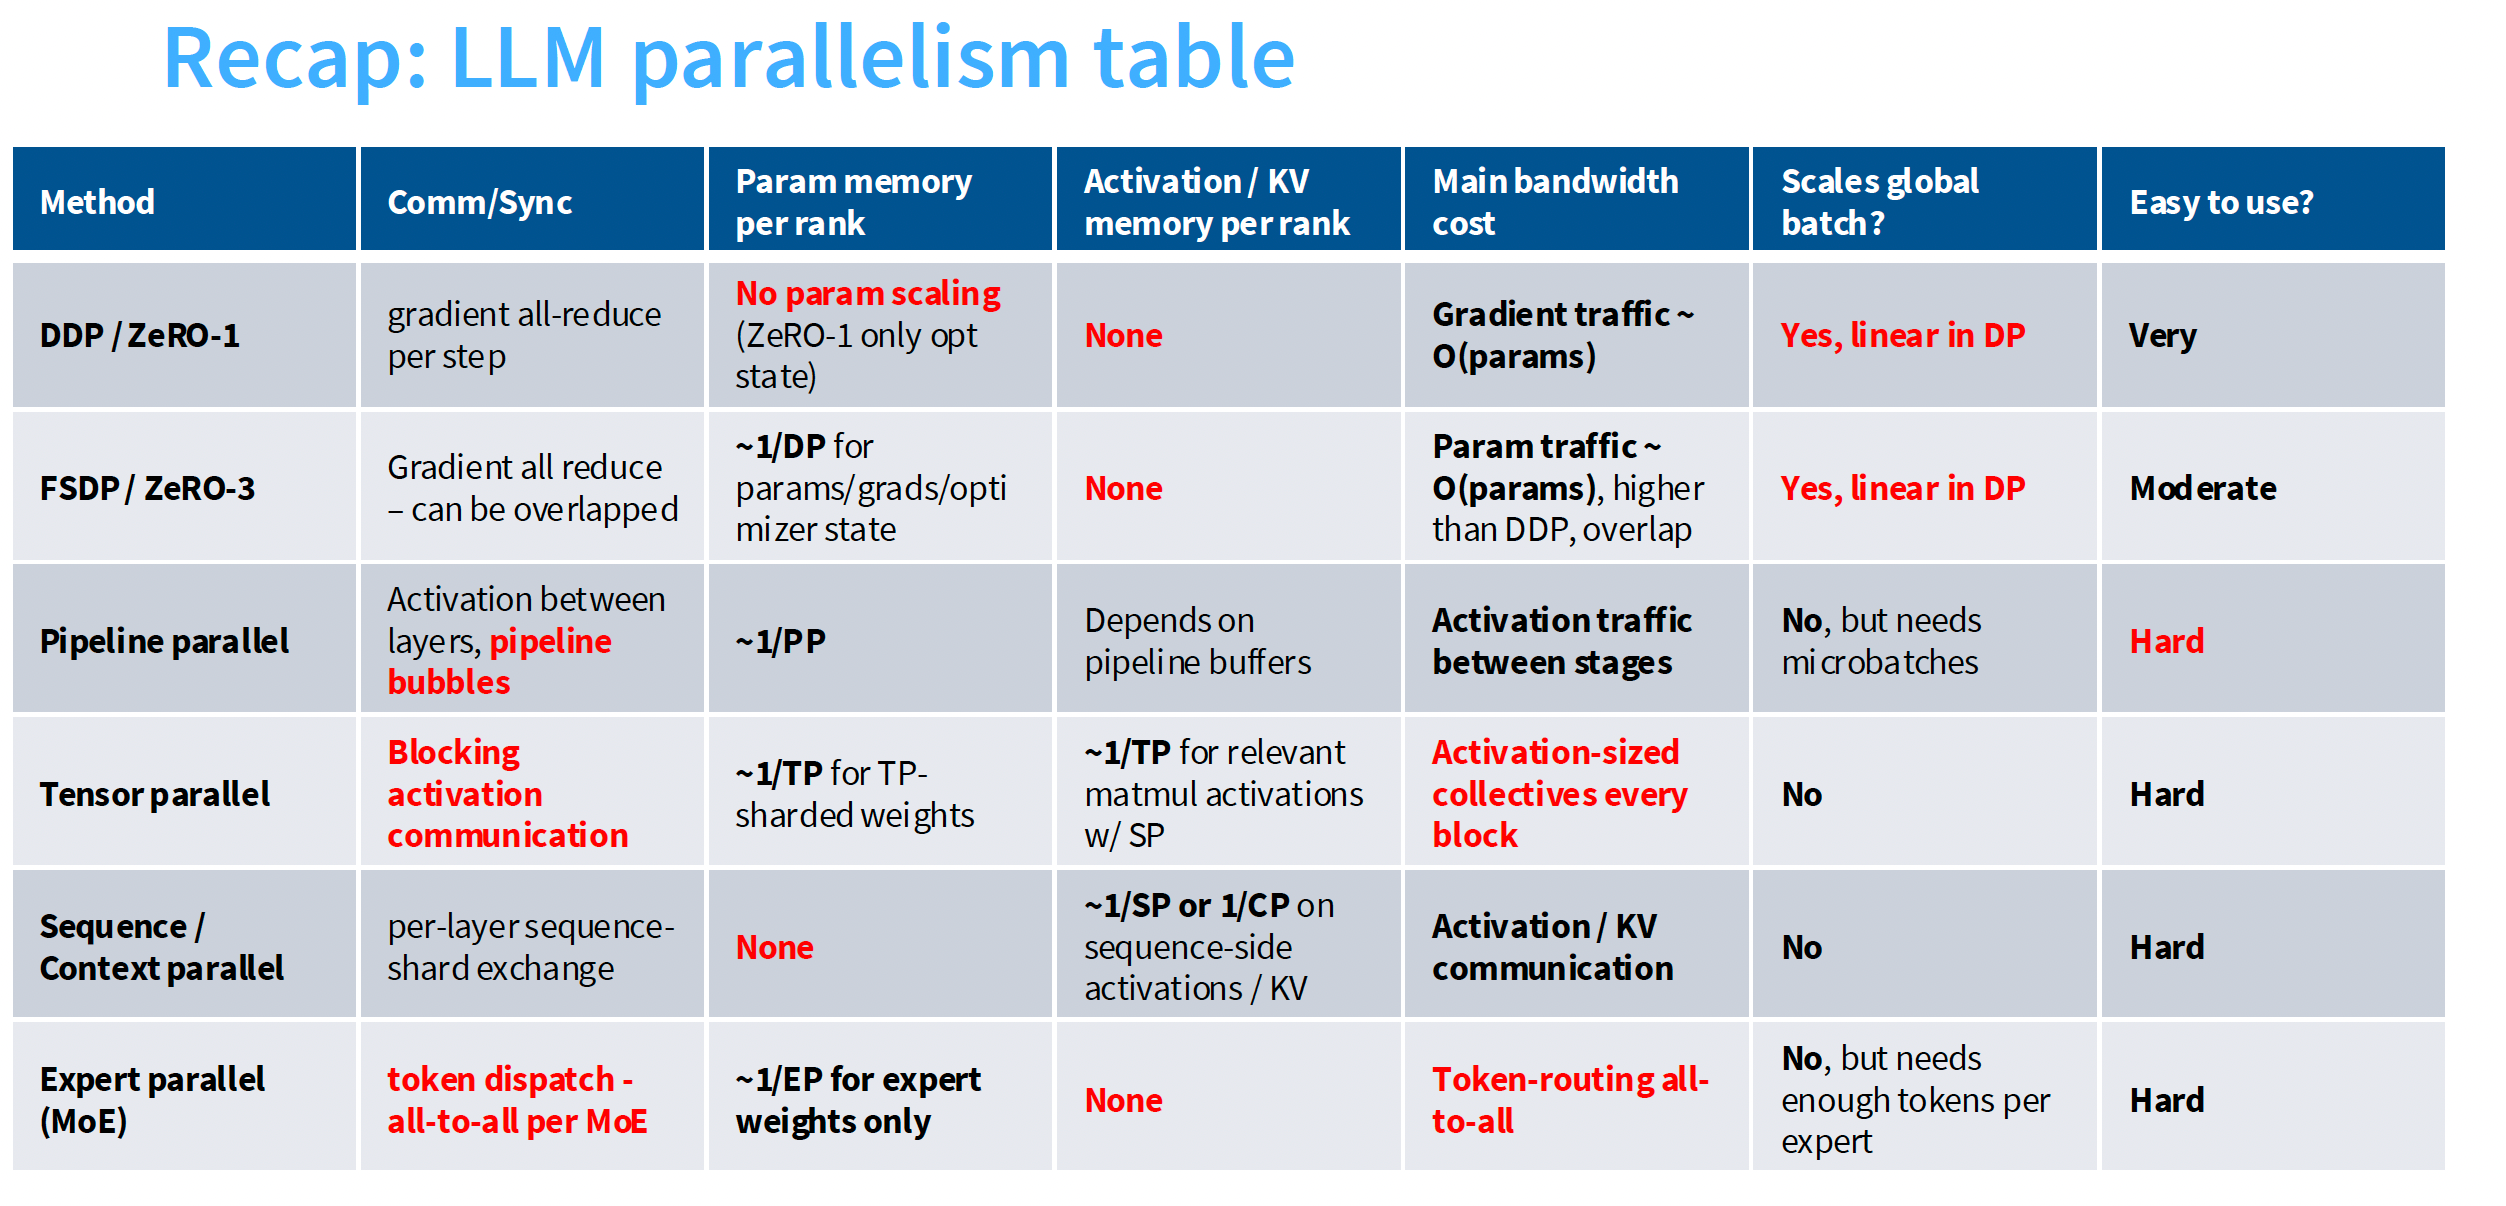
各种并行化策略各自有优缺点,详细参见上图。多种方法可以联合起来共同使用,以提高 GPU 的计算占用率。